探索aarch64架构上使用ftrace的BPF LSM 译者注 笔者在MacBook M2上搭建Linux虚拟机上开发eBPF程序时,遇到一些LSM eBPF类型程序无法运行的问题。 在笔者尝试定位这些差异时,看到这篇文章,可以让大家更直观地了解LSM eBPF在ARM64、AMD64 内核上的差异。 原文地址:Exploring BPF LSM support on aarch64 with ftrace 原文 本博客文章是我们在Linux中对于aarch64上BPF LSM支持的内部研究的摘要。如果你对内核代码库不熟悉,要开始查看内核源码是非常困难的,因此我们决定发布这篇文章,展示我们的方法,因为这对于想要探索内核内部的任何人都可能有所帮助。 简介 在x86_64上,我们已经在使用BPF LSM,而在aarch64上,我们依赖于Kprobes,因此我们想知道内核中缺少了哪些功能,才能让这些功能在aarch64上可用。 我们曾多次深入研究内核源代码,但通常我们搜索的是已经存在的东西,以了解其工作原理。但在这种情况下,我们在寻找的是不存在的东西,我们追寻的是那些因为未实现而返回错误的内容。 回想起Steven Rostedt关于如何开始学习Linux内核的讲话,我们从ftrace(以及构建在跟踪基础设施上的工具)开始,以了解当我们将一个不受支持的BPF程序加载到内核时会发生什么。 问题 这是当我们尝试将一个BPF LSM程序加载到aarch64 5.15 Linux内核时,使用我们的软件pulsar时的输出: root@pine64-1:/home/exein# ./pulsar-enterprise-exec pulsard [2023-02-16T14:52:45Z INFO pulsar::pulsard::daemon] Starting module process-monitor [2023-02-16T14:52:45Z INFO pulsar::pulsard::daemon] Starting module file-system-monitor [2023-02-16T14:52:46Z INFO pulsar::pulsard::daemon] Starting module network-monitor [2023-02-16T14:52:46Z INFO pulsar::pulsard::daemon] Starting module logger [2023-02-16T14:52:46Z INFO pulsar::pulsard::daemon] Starting module rules-engine [2023-02-16T14:52:46Z INFO pulsar::pulsard::daemon] Starting module desktop-notifier [2023-02-16T14:52:46Z ERROR pulsar::pulsard::module_manager] Module error in file-system-monitor: failed program attach lsm path_mknod Caused by: 0: `bpf_raw_tracepoint_open` failed 1: No error information (os error 524) [2023-02-16T14:52:46Z INFO pulsar::pulsard::daemon] Starting module anomaly-detection [2023-02-16T14:52:46Z INFO pulsar::pulsard::daemon] Starting module malware-detection [2023-02-16T14:52:46Z ERROR pulsar::pulsard::module_manager] Module error in malware-detection: /var/lib/pulsar/malware_detection/models/parameters.json not found [2023-02-16T14:52:46Z INFO pulsar::pulsard::daemon] Starting module platform-connector [2023-02-16T14:52:46Z INFO platform_connector::client] Connected to https://platform-dev-instance.exein.io:8001/ [2023-02-16T14:52:46Z INFO pulsar::pulsard::daemon] Starting module threat-response [2023-02-16T14:52:46Z ERROR pulsar::pulsard::module_manager] Module error in network-monitor: failed program attach lsm socket_bind Caused by: 0: `bpf_raw_tracepoint_open` failed 1: No error information (os error 524) 我们在尝试加载与path_mknodLSM挂钩相关的BPF程序时,pulsar出现了错误524或ENOTSUPP。让我们尝试深入研究这个问题。 注意: 在进行这项研究时,我们当时无法找到预先编译为启用BPF和BTF的aarch64,因此我们不得不编译一个自定义内核。我们还启用了跟踪选项和function_graph插件,以使用下面的工具。 所有的实验都是在一台装有定制Armbian镜像的Pine A64上进行的。 这些镜像具有带有标准Ubuntu 22.04 LTS Jammy用户空间的自定义内核。 工具 为了调查这个问题,我们使用了以下工具: bpftrace:基于BPF的工具,使用自定义类C语言动态附加探针。 trace-cmd:围绕tracefs文件系统的包装器,与ftrace基础设施交互。 要使用这些工具,您需要在Linux内核中启用一些选项,请查阅官方文档获取完整的要求。 注意: 也可以使用其他工具来完成相同的工作,例如perf-tools中的funcgraph和kprobe。 Linux 5.15 现在我们开始使用这些工具来查看在内核5.15中尝试加载我们的BPF程序时会发生什么。 从这一点开始到本文末尾,我们将使用probe二进制文件代替pulsar,因为它更简单。为了简要概括其工作原理,以下是命令行帮助: exein@pine64-1:~$ ./probe Test runner for eBPF programs Usage: probe [OPTIONS] <COMMAND> Commands: file-system-monitor Watch file creations process-monitor Watch process events (fork/exec/exit) network-monitor Watch network events help Print this message or the help of the given subcommand(s) Options: -v, --verbose -h, --help Print help -V, --version Print version 在这些示例中,我们将尝试加载file-system-monitor探针。 通过运行以下命令,我们可以看到__sys_bpf函数的函数图调用,这是BPF系统调用的入口点: trace-cmd record -p function_graph -g __sys_bpf ./probe file-system-monitor trace-cmd report 输出是一个非常庞大的函数图,太大了,无法在这里粘贴。由于我们遇到了错误,我们对程序停止前的最后几个函数感兴趣。以下是trace-cmd report输出的最后几行: ... tokio-runtime-w-1666 [003] 1318.058019: funcgraph_entry: | bpf_trampoline_link_prog() { tokio-runtime-w-1666 [003] 1318.058020: funcgraph_entry: 2.292 us | bpf_attach_type_to_tramp(); tokio-runtime-w-1666 [003] 1318.058024: funcgraph_entry: 1.250 us | mutex_lock(); tokio-runtime-w-1666 [003] 1318.058028: funcgraph_entry: | bpf_trampoline_update() { tokio-runtime-w-1666 [003] 1318.058030: funcgraph_entry: | kmem_cache_alloc_trace() { tokio-runtime-w-1666 [003] 1318.058031: funcgraph_entry: 1.167 us | should_failslab(); tokio-runtime-w-1666 [003] 1318.058036: funcgraph_exit: 6.792 us | } tokio-runtime-w-1666 [003] 1318.058039: funcgraph_entry: | kmem_cache_alloc_trace() { tokio-runtime-w-1666 [003] 1318.058042: funcgraph_entry: 2.750 us | should_failslab(); tokio-runtime-w-1666 [003] 1318.058046: funcgraph_exit: 6.417 us | } tokio-runtime-w-1666 [003] 1318.058048: funcgraph_entry: 2.708 us | bpf_jit_charge_modmem(); tokio-runtime-w-1666 [003] 1318.058053: funcgraph_entry: | bpf_jit_alloc_exec_page() { tokio-runtime-w-1666 [003] 1318.058055: funcgraph_entry: | bpf_jit_alloc_exec() { tokio-runtime-w-1666 [003] 1318.058057: funcgraph_entry: | vmalloc() { tokio-runtime-w-1666 [003] 1318.058059: funcgraph_entry: | __vmalloc_node() { tokio-runtime-w-1666 [003] 1318.058061: funcgraph_entry: | __vmalloc_node_range() { tokio-runtime-w-1666 [003] 1318.058064: funcgraph_entry: | __get_vm_area_node.constprop.64() { tokio-runtime-w-1666 [003] 1318.058067: funcgraph_entry: | kmem_cache_alloc_node_trace() { tokio-runtime-w-1666 [003] 1318.058069: funcgraph_entry: 1.459 us | should_failslab(); tokio-runtime-w-1666 [003] 1318.058073: funcgraph_exit: 6.292 us | } tokio-runtime-w-1666 [003] 1318.058075: funcgraph_entry: | alloc_vmap_area() { tokio-runtime-w-1666 [003] 1318.058077: funcgraph_entry: | kmem_cache_alloc_node() { tokio-runtime-w-1666 [003] 1318.058079: funcgraph_entry: 1.167 us | should_failslab(); tokio-runtime-w-1666 [003] 1318.058085: funcgraph_exit: 7.625 us | } tokio-runtime-w-1666 [003] 1318.058088: funcgraph_entry: | kmem_cache_alloc_node() { tokio-runtime-w-1666 [003] 1318.058089: funcgraph_entry: 1.208 us | should_failslab(); tokio-runtime-w-1666 [003] 1318.058092: funcgraph_exit: 4.584 us | } tokio-runtime-w-1666 [003] 1318.058104: funcgraph_entry: | kmem_cache_free() { tokio-runtime-w-1666 [003] 1318.058107: funcgraph_entry: 2.084 us | __slab_free(); tokio-runtime-w-1666 [003] 1318.058110: funcgraph_exit: 5.667 us | } tokio-runtime-w-1666 [003] 1318.058112: funcgraph_entry: 6.375 us | insert_vmap_area.constprop.74(); tokio-runtime-w-1666 [003] 1318.058119: funcgraph_exit: + 44.667 us | } tokio-runtime-w-1666 [003] 1318.058122: funcgraph_exit: + 58.250 us | } tokio-runtime-w-1666 [003] 1318.058124: funcgraph_entry: | __kmalloc_node() { tokio-runtime-w-1666 [003] 1318.058125: funcgraph_entry: 1.625 us | kmalloc_slab(); tokio-runtime-w-1666 [003] 1318.058128: funcgraph_entry: 1.167 us | should_failslab(); tokio-runtime-w-1666 [003] 1318.058131: funcgraph_exit: 7.208 us | } tokio-runtime-w-1666 [003] 1318.058133: funcgraph_entry: | alloc_pages() { tokio-runtime-w-1666 [003] 1318.058135: funcgraph_entry: 1.583 us | get_task_policy.part.48(); tokio-runtime-w-1666 [003] 1318.058138: funcgraph_entry: 1.500 us | policy_node(); tokio-runtime-w-1666 [003] 1318.058141: funcgraph_entry: 1.209 us | policy_nodemask(); tokio-runtime-w-1666 [003] 1318.058143: funcgraph_entry: | __alloc_pages() { tokio-runtime-w-1666 [003] 1318.058145: funcgraph_entry: 1.458 us | should_fail_alloc_page(); tokio-runtime-w-1666 [003] 1318.058147: funcgraph_entry: | get_page_from_freelist() { tokio-runtime-w-1666 [003] 1318.058150: funcgraph_entry: 1.583 us | prep_new_page(); tokio-runtime-w-1666 [003] 1318.058153: funcgraph_exit: 5.459 us | } tokio-runtime-w-1666 [003] 1318.058154: funcgraph_exit: + 10.542 us | } tokio-runtime-w-1666 [003] 1318.058155: funcgraph_exit: + 22.083 us | } tokio-runtime-w-1666 [003] 1318.058157: funcgraph_entry: | __cond_resched() { tokio-runtime-w-1666 [003] 1318.058158: funcgraph_entry: 1.833 us | rcu_all_qs(); tokio-runtime-w-1666 [003] 1318.058161: funcgraph_exit: 4.167 us | } tokio-runtime-w-1666 [003] 1318.058166: funcgraph_entry: 5.542 us | vmap_pages_range_noflush(); tokio-runtime-w-1666 [003] 1318.058173: funcgraph_exit: ! 112.375 us | } tokio-runtime-w-1666 [003] 1318.058175: funcgraph_exit: ! 116.000 us | } tokio-runtime-w-1666 [003] 1318.058176: funcgraph_exit: ! 119.292 us | } tokio-runtime-w-1666 [003] 1318.058177: funcgraph_exit: ! 122.542 us | } tokio-runtime-w-1666 [003] 1318.058179: funcgraph_entry: | find_vm_area() { tokio-runtime-w-1666 [003] 1318.058180: funcgraph_entry: 1.375 us | find_vmap_area(); tokio-runtime-w-1666 [003] 1318.058183: funcgraph_exit: 4.333 us | } tokio-runtime-w-1666 [003] 1318.058185: funcgraph_entry: | set_memory_x() { tokio-runtime-w-1666 [003] 1318.058186: funcgraph_entry: | change_memory_common() { tokio-runtime-w-1666 [003] 1318.058188: funcgraph_entry: | find_vm_area() { tokio-runtime-w-1666 [003] 1318.058189: funcgraph_entry: 1.333 us | find_vmap_area(); tokio-runtime-w-1666 [003] 1318.058192: funcgraph_exit: 3.875 us | } tokio-runtime-w-1666 [003] 1318.058193: funcgraph_entry: | vm_unmap_aliases() { tokio-runtime-w-1666 [003] 1318.058194: funcgraph_entry: | _vm_unmap_aliases.part.58() { tokio-runtime-w-1666 [003] 1318.058196: funcgraph_entry: 1.542 us | rcu_read_unlock_strict(); tokio-runtime-w-1666 [003] 1318.058199: funcgraph_entry: 1.208 us | rcu_read_unlock_strict(); tokio-runtime-w-1666 [003] 1318.058202: funcgraph_entry: 1.166 us | rcu_read_unlock_strict(); tokio-runtime-w-1666 [003] 1318.058205: funcgraph_entry: 1.208 us | rcu_read_unlock_strict(); tokio-runtime-w-1666 [003] 1318.058207: funcgraph_entry: 1.208 us | mutex_lock(); tokio-runtime-w-1666 [003] 1318.058210: funcgraph_entry: | purge_fragmented_blocks_allcpus() { tokio-runtime-w-1666 [003] 1318.058212: funcgraph_entry: 1.500 us | rcu_read_unlock_strict(); tokio-runtime-w-1666 [003] 1318.058214: funcgraph_entry: 1.500 us | rcu_read_unlock_strict(); tokio-runtime-w-1666 [003] 1318.058217: funcgraph_entry: 1.500 us | rcu_read_unlock_strict(); tokio-runtime-w-1666 [003] 1318.058220: funcgraph_entry: 1.167 us | rcu_read_unlock_strict(); tokio-runtime-w-1666 [003] 1318.058222: funcgraph_exit: + 11.917 us | } tokio-runtime-w-1666 [003] 1318.058224: funcgraph_entry: | __purge_vmap_area_lazy() { tokio-runtime-w-1666 [003] 1318.058232: funcgraph_entry: | kmem_cache_free() { tokio-runtime-w-1666 [003] 1318.058234: funcgraph_entry: 1.250 us | __slab_free(); tokio-runtime-w-1666 [003] 1318.058237: funcgraph_exit: 4.791 us | } tokio-runtime-w-1666 [003] 1318.058241: funcgraph_entry: 1.209 us | __cond_resched_lock(); tokio-runtime-w-1666 [003] 1318.058244: funcgraph_exit: + 19.625 us | } tokio-runtime-w-1666 [003] 1318.058245: funcgraph_entry: 1.167 us | mutex_unlock(); tokio-runtime-w-1666 [003] 1318.058247: funcgraph_exit: + 53.042 us | } tokio-runtime-w-1666 [003] 1318.058248: funcgraph_exit: + 55.625 us | } tokio-runtime-w-1666 [003] 1318.058250: funcgraph_entry: | __change_memory_common() { tokio-runtime-w-1666 [003] 1318.058251: funcgraph_entry: | apply_to_page_range() { tokio-runtime-w-1666 [003] 1318.058253: funcgraph_entry: | __apply_to_page_range() { tokio-runtime-w-1666 [003] 1318.058255: funcgraph_entry: 1.250 us | pud_huge(); tokio-runtime-w-1666 [003] 1318.058258: funcgraph_entry: 1.166 us | pmd_huge(); tokio-runtime-w-1666 [003] 1318.058260: funcgraph_entry: 1.208 us | change_page_range(); tokio-runtime-w-1666 [003] 1318.058263: funcgraph_exit: 9.834 us | } tokio-runtime-w-1666 [003] 1318.058264: funcgraph_exit: + 12.709 us | } tokio-runtime-w-1666 [003] 1318.058266: funcgraph_exit: + 15.459 us | } tokio-runtime-w-1666 [003] 1318.058268: funcgraph_exit: + 80.791 us | } tokio-runtime-w-1666 [003] 1318.058270: funcgraph_exit: + 84.834 us | } tokio-runtime-w-1666 [003] 1318.058272: funcgraph_exit: ! 218.500 us | } tokio-runtime-w-1666 [003] 1318.058274: funcgraph_entry: | __alloc_percpu_gfp() { tokio-runtime-w-1666 [003] 1318.058276: funcgraph_entry: | pcpu_alloc() { tokio-runtime-w-1666 [003] 1318.058281: funcgraph_entry: 2.250 us | mutex_lock_killable(); tokio-runtime-w-1666 [003] 1318.058290: funcgraph_entry: | pcpu_find_block_fit() { tokio-runtime-w-1666 [003] 1318.058293: funcgraph_entry: 2.833 us | pcpu_next_fit_region.constprop.38(); tokio-runtime-w-1666 [003] 1318.058299: funcgraph_exit: 9.084 us | } tokio-runtime-w-1666 [003] 1318.058301: funcgraph_entry: | pcpu_alloc_area() { tokio-runtime-w-1666 [003] 1318.058315: funcgraph_entry: 4.000 us | pcpu_block_update_hint_alloc(); tokio-runtime-w-1666 [003] 1318.058320: funcgraph_entry: 2.208 us | pcpu_chunk_relocate(); tokio-runtime-w-1666 [003] 1318.058324: funcgraph_exit: + 22.625 us | } tokio-runtime-w-1666 [003] 1318.058327: funcgraph_entry: 1.208 us | mutex_unlock(); tokio-runtime-w-1666 [003] 1318.058332: funcgraph_entry: 1.584 us | pcpu_memcg_post_alloc_hook(); tokio-runtime-w-1666 [003] 1318.058335: funcgraph_exit: + 58.833 us | } tokio-runtime-w-1666 [003] 1318.058336: funcgraph_exit: + 61.834 us | } tokio-runtime-w-1666 [003] 1318.058338: funcgraph_entry: | kmem_cache_alloc_trace() { tokio-runtime-w-1666 [003] 1318.058339: funcgraph_entry: 1.167 us | should_failslab(); tokio-runtime-w-1666 [003] 1318.058342: funcgraph_exit: 4.458 us | } tokio-runtime-w-1666 [003] 1318.058359: funcgraph_entry: | bpf_image_ksym_add() { tokio-runtime-w-1666 [003] 1318.058360: funcgraph_entry: | bpf_ksym_add() { tokio-runtime-w-1666 [003] 1318.058363: funcgraph_entry: 1.583 us | __local_bh_enable_ip(); tokio-runtime-w-1666 [003] 1318.058366: funcgraph_exit: 5.750 us | } tokio-runtime-w-1666 [003] 1318.058369: funcgraph_exit: 9.834 us | } tokio-runtime-w-1666 [003] 1318.058371: funcgraph_entry: 1.250 us | arch_prepare_bpf_trampoline(); tokio-runtime-w-1666 [003] 1318.058373: funcgraph_entry: 2.292 us | kfree(); tokio-runtime-w-1666 [003] 1318.058377: funcgraph_exit: ! 348.625 us | } tokio-runtime-w-1666 [003] 1318.058379: funcgraph_entry: 1.250 us | mutex_unlock(); tokio-runtime-w-1666 [003] 1318.058382: funcgraph_exit: ! 363.167 us | } tokio-runtime-w-1666 [003] 1318.058384: funcgraph_entry: | bpf_link_cleanup() { tokio-runtime-w-1666 [003] 1318.058386: funcgraph_entry: | bpf_link_free_id.part.30() { tokio-runtime-w-1666 [003] 1318.058392: funcgraph_entry: | call_rcu() { tokio-runtime-w-1666 [003] 1318.058396: funcgraph_entry: 1.834 us | rcu_segcblist_enqueue(); tokio-runtime-w-1666 [003] 1318.058401: funcgraph_exit: 9.333 us | } tokio-runtime-w-1666 [003] 1318.058403: funcgraph_entry: 1.542 us | __local_bh_enable_ip(); tokio-runtime-w-1666 [003] 1318.058406: funcgraph_exit: + 19.542 us | } tokio-runtime-w-1666 [003] 1318.058408: funcgraph_entry: | fput() { tokio-runtime-w-1666 [003] 1318.058409: funcgraph_entry: | fput_many() { tokio-runtime-w-1666 [003] 1318.058411: funcgraph_entry: | task_work_add() { tokio-runtime-w-1666 [003] 1318.058414: funcgraph_entry: 1.625 us | kick_process(); tokio-runtime-w-1666 [003] 1318.058418: funcgraph_exit: 6.750 us | } tokio-runtime-w-1666 [003] 1318.058419: funcgraph_exit: + 10.333 us | } tokio-runtime-w-1666 [003] 1318.058420: funcgraph_exit: + 12.708 us | } tokio-runtime-w-1666 [003] 1318.058422: funcgraph_entry: 2.250 us | put_unused_fd(); tokio-runtime-w-1666 [003] 1318.058426: funcgraph_exit: + 41.416 us | } tokio-runtime-w-1666 [003] 1318.058428: funcgraph_entry: 1.292 us | mutex_unlock(); tokio-runtime-w-1666 [003] 1318.058430: funcgraph_entry: 1.250 us | kfree(); tokio-runtime-w-1666 [003] 1318.058433: funcgraph_exit: ! 567.458 us | } tokio-runtime-w-1666 [003] 1318.058435: funcgraph_entry: 2.125 us | __bpf_prog_put.isra.47(); tokio-runtime-w-1666 [003] 1318.058438: funcgraph_exit: ! 602.291 us | } tokio-runtime-w-1666 [003] 1318.058439: funcgraph_exit: ! 631.791 us | } ```shell 这是<code>kernel/bpf/trampoline.c</code>中与最后执行的函数<code>bpf_trampoline_update</code>对应的源代码: ```c static int bpf_trampoline_update(struct bpf_trampoline *tr) { struct bpf_tramp_image *im; struct bpf_tramp_progs *tprogs; u32 flags = BPF_TRAMP_F_RESTORE_REGS; bool ip_arg = false; int err, total; tprogs = bpf_trampoline_get_progs(tr, &total, &ip_arg); if (IS_ERR(tprogs)) return PTR_ERR(tprogs); if (total == 0) { err = unregister_fentry(tr, tr->cur_image->image); bpf_tramp_image_put(tr->cur_image); tr->cur_image = NULL; tr->selector = 0; goto out; } im = bpf_tramp_image_alloc(tr->key, tr->selector); if (IS_ERR(im)) { err = PTR_ERR(im); goto out; } if (tprogs[BPF_TRAMP_FEXIT].nr_progs || tprogs[BPF_TRAMP_MODIFY_RETURN].nr_progs) flags = BPF_TRAMP_F_CALL_ORIG | BPF_TRAMP_F_SKIP_FRAME; if (ip_arg) flags |= BPF_TRAMP_F_IP_ARG; err = arch_prepare_bpf_trampoline(im, im->image, im->image + PAGE_SIZE, &tr->func.model, flags, tprogs, tr->func.addr); if (err < 0) goto out; WARN_ON(tr->cur_image && tr->selector == 0); WARN_ON(!tr->cur_image && tr->selector); if (tr->cur_image) /* progs already running at this address */ err = modify_fentry(tr, tr->cur_image->image, im->image); else /* first time registering */ err = register_fentry(tr, im->image); if (err) goto out; if (tr->cur_image) bpf_tramp_image_put(tr->cur_image); tr->cur_image = im; tr->selector++; out: kfree(tprogs); return err; } 根据先前的输出,我们可以看到: tokio-runtime-w-1666 [003] 1318.058371: funcgraph_entry: 1.250 us | arch_prepare_bpf_trampoline(); tokio-runtime-w-1666 [003] 1318.058373: funcgraph_entry: 2.292 us | kfree(); 在arch_prepare_bpf_trampoline和kfree函数之间没有其他函数调用,所以很可能第一个函数在err变量中返回了错误代码。让我们来验证一下! 通过以下方式在shell中启动bpftace,我们可以捕获arch_prepare_bpf_trampoline函数的返回值并将其打印到控制台上: bpftrace -e 'kretprobe:arch_prepare_bpf_trampoline { printf("retval link: %d\n", retval); }' 并且在另一个终端中启动probe后,我们从bpftace得到了以下输出: root@pine64-1:/home/exein# bpftrace -e 'kretprobe:arch_prepare_bpf_trampoline { printf("retval link: %d\n", retval); }' Attaching 1 probe... retval link: -524 这是因为内核5.15缺乏对aarch64架构的arch_prepare_bpf_trampoline实现,并使用了默认的占位符实现。 int __weak arch_prepare_bpf_trampoline(struct bpf_tramp_image *tr, void *image, void *image_end, const struct btf_func_model *m, u32 flags, struct bpf_tramp_links *tlinks, void *orig_call) { return -ENOTSUPP; } 因此,这个功能在这个内核版本上是不受支持的。好消息是,多亏了这个补丁,它在6.x内核中得到了实现。 让我们移步到6.x内核。 Linux 6.1 如果我们尝试在内核 6.1 上运行 probe,我们会得到以下输出: root@pine64:/home/exein# ./probe file-system-monitor thread 'main' panicked at 'initialization failed: ProgramAttachError { program: "lsm path_mknod", program_error: SyscallError { call: "bpf_raw_tracepoint_open", io_error: Os { code: 524, kind: Uncategorized, message: "No error information" } } }', src/bin/probe.rs:72:43 note: run with `RUST_BACKTRACE=1` environment variable to display a backtrace 对于内核版本6.1,我们仍然遇到了和5.15内核一样的错误!!!让我们找出其中的原因。 这次在arch_prepare_bpf_trampoline上运行bpftrace,我们得到了以下输出: root@pine64:/home/exein# bpftrace -e 'kretprobe:arch_prepare_bpf_trampoline { printf("retval tp link: %d\n", retval); }' Attaching 1 probe... retval tp link: 284 所以问题不在这里,这个函数不再返回错误了。让我们回到函数调用图。 这次我们启动trace-cmd,跳过一些函数以获得更清晰的输出: trace-cmd record \ -p function_graph \ -g bpf_trampoline_link_prog \ -n bpf_jit_alloc_exec \ -n kmalloc_trace \ -n arch_prepare_bpf_trampoline \ -n generic_handle_domain_irq \ -n do_interrupt_handler \ -n irq_exit_rcu \ ./probe file-system-monitor 我们从trace-cmd report中获得以下输出: root@pine64:/home/exein# trace-cmd report CPU 0 is empty CPU 1 is empty CPU 3 is empty cpus=4 tokio-runtime-w-11886 [002] 193385.056283: funcgraph_entry: | bpf_trampoline_link_prog() { tokio-runtime-w-11886 [002] 193385.056321: funcgraph_entry: + 15.042 us | mutex_lock(); tokio-runtime-w-11886 [002] 193385.056373: funcgraph_entry: | __bpf_trampoline_link_prog() { tokio-runtime-w-11886 [002] 193385.056395: funcgraph_entry: + 14.833 us | bpf_attach_type_to_tramp(); tokio-runtime-w-11886 [002] 193385.056428: funcgraph_entry: | bpf_trampoline_update.isra.23() { tokio-runtime-w-11886 [002] 193385.056459: funcgraph_entry: 2.917 us | bpf_jit_charge_modmem(); tokio-runtime-w-11886 [002] 193385.056531: funcgraph_entry: | find_vm_area() { tokio-runtime-w-11886 [002] 193385.056540: funcgraph_entry: 3.000 us | find_vmap_area(); tokio-runtime-w-11886 [002] 193385.056547: funcgraph_exit: + 16.208 us | } tokio-runtime-w-11886 [002] 193385.056554: funcgraph_entry: | __alloc_percpu_gfp() { tokio-runtime-w-11886 [002] 193385.056563: funcgraph_entry: | pcpu_alloc() { tokio-runtime-w-11886 [002] 193385.056568: funcgraph_entry: 4.875 us | mutex_lock_killable(); tokio-runtime-w-11886 [002] 193385.056591: funcgraph_entry: | pcpu_find_block_fit() { tokio-runtime-w-11886 [002] 193385.056599: funcgraph_entry: 8.625 us | pcpu_next_fit_region.constprop.38(); tokio-runtime-w-11886 [002] 193385.056608: funcgraph_exit: + 17.166 us | } tokio-runtime-w-11886 [002] 193385.056610: funcgraph_entry: | pcpu_alloc_area() { tokio-runtime-w-11886 [002] 193385.056639: funcgraph_entry: 9.167 us | pcpu_block_update(); tokio-runtime-w-11886 [002] 193385.056656: funcgraph_entry: 7.667 us | pcpu_block_update_hint_alloc(); tokio-runtime-w-11886 [002] 193385.056671: funcgraph_entry: 7.750 us | pcpu_chunk_relocate(); tokio-runtime-w-11886 [002] 193385.056679: funcgraph_exit: + 69.667 us | } tokio-runtime-w-11886 [002] 193385.056682: funcgraph_entry: 7.042 us | mutex_unlock(); tokio-runtime-w-11886 [002] 193385.056703: funcgraph_entry: 2.792 us | pcpu_memcg_post_alloc_hook(); tokio-runtime-w-11886 [002] 193385.056712: funcgraph_exit: ! 148.709 us | } tokio-runtime-w-11886 [002] 193385.056719: funcgraph_exit: ! 165.250 us | } tokio-runtime-w-11886 [002] 193385.056866: funcgraph_entry: | bpf_image_ksym_add() { tokio-runtime-w-11886 [002] 193385.056873: funcgraph_entry: | bpf_ksym_add() { tokio-runtime-w-11886 [002] 193385.056882: funcgraph_entry: 2.750 us | __local_bh_disable_ip(); tokio-runtime-w-11886 [002] 193385.056897: funcgraph_entry: 4.625 us | __local_bh_enable_ip(); tokio-runtime-w-11886 [002] 193385.056905: funcgraph_exit: + 32.459 us | } tokio-runtime-w-11886 [002] 193385.056922: funcgraph_entry: 7.584 us | perf_event_ksymbol(); tokio-runtime-w-11886 [002] 193385.056944: funcgraph_exit: + 78.417 us | } tokio-runtime-w-11886 [002] 193385.057492: funcgraph_entry: | set_memory_ro() { tokio-runtime-w-11886 [002] 193385.057501: funcgraph_entry: | change_memory_common() { tokio-runtime-w-11886 [002] 193385.057504: funcgraph_entry: | find_vm_area() { tokio-runtime-w-11886 [002] 193385.057506: funcgraph_entry: 8.875 us | find_vmap_area(); tokio-runtime-w-11886 [002] 193385.057518: funcgraph_exit: + 14.250 us | } tokio-runtime-w-11886 [002] 193385.057522: funcgraph_entry: | __change_memory_common() { tokio-runtime-w-11886 [002] 193385.057531: funcgraph_entry: | apply_to_page_range() { tokio-runtime-w-11886 [002] 193385.057538: funcgraph_entry: | __apply_to_page_range() { tokio-runtime-w-11886 [002] 193385.057544: funcgraph_entry: + 12.791 us | pud_huge(); tokio-runtime-w-11886 [002] 193385.057559: funcgraph_entry: 2.708 us | pmd_huge(); tokio-runtime-w-11886 [002] 193385.057574: funcgraph_entry: + 15.125 us | change_page_range(); tokio-runtime-w-11886 [002] 193385.057591: funcgraph_exit: + 53.792 us | } tokio-runtime-w-11886 [002] 193385.057597: funcgraph_exit: + 66.083 us | } tokio-runtime-w-11886 [002] 193385.057610: funcgraph_exit: + 88.125 us | } tokio-runtime-w-11886 [002] 193385.057619: funcgraph_entry: | vm_unmap_aliases() { tokio-runtime-w-11886 [002] 193385.057622: funcgraph_entry: | _vm_unmap_aliases.part.77() { tokio-runtime-w-11886 [002] 193385.057625: funcgraph_entry: 9.125 us | mutex_lock(); tokio-runtime-w-11886 [002] 193385.057637: funcgraph_entry: 3.084 us | purge_fragmented_blocks_allcpus(); tokio-runtime-w-11886 [002] 193385.057643: funcgraph_entry: | __purge_vmap_area_lazy() { tokio-runtime-w-11886 [002] 193385.057687: funcgraph_entry: | kmem_cache_free() { tokio-runtime-w-11886 [002] 193385.057693: funcgraph_entry: + 13.250 us | __slab_free(); tokio-runtime-w-11886 [002] 193385.057705: funcgraph_exit: + 18.750 us | } tokio-runtime-w-11886 [002] 193385.057718: funcgraph_entry: 7.416 us | __cond_resched_lock(); tokio-runtime-w-11886 [002] 193385.057733: funcgraph_exit: + 90.042 us | } tokio-runtime-w-11886 [002] 193385.057741: funcgraph_entry: 2.792 us | mutex_unlock(); tokio-runtime-w-11886 [002] 193385.057747: funcgraph_exit: ! 124.666 us | } tokio-runtime-w-11886 [002] 193385.057749: funcgraph_exit: ! 130.291 us | } tokio-runtime-w-11886 [002] 193385.057756: funcgraph_entry: | __change_memory_common() { tokio-runtime-w-11886 [002] 193385.057759: funcgraph_entry: | apply_to_page_range() { tokio-runtime-w-11886 [002] 193385.057765: funcgraph_entry: | __apply_to_page_range() { tokio-runtime-w-11886 [002] 193385.057768: funcgraph_entry: 4.125 us | pud_huge(); tokio-runtime-w-11886 [002] 193385.057778: funcgraph_entry: 8.750 us | pmd_huge(); tokio-runtime-w-11886 [002] 193385.057790: funcgraph_entry: 4.625 us | change_page_range(); tokio-runtime-w-11886 [002] 193385.057797: funcgraph_exit: + 31.958 us | } tokio-runtime-w-11886 [002] 193385.057803: funcgraph_exit: + 44.375 us | } tokio-runtime-w-11886 [002] 193385.057817: funcgraph_exit: + 61.208 us | } tokio-runtime-w-11886 [002] 193385.057820: funcgraph_exit: ! 319.292 us | } tokio-runtime-w-11886 [002] 193385.057826: funcgraph_exit: ! 333.667 us | } tokio-runtime-w-11886 [002] 193385.057840: funcgraph_entry: | set_memory_x() { tokio-runtime-w-11886 [002] 193385.057847: funcgraph_entry: | change_memory_common() { tokio-runtime-w-11886 [002] 193385.057855: funcgraph_entry: | find_vm_area() { tokio-runtime-w-11886 [002] 193385.057858: funcgraph_entry: 2.917 us | find_vmap_area(); tokio-runtime-w-11886 [002] 193385.057870: funcgraph_exit: + 14.375 us | } tokio-runtime-w-11886 [002] 193385.057876: funcgraph_entry: | vm_unmap_aliases() { tokio-runtime-w-11886 [002] 193385.057879: funcgraph_entry: | _vm_unmap_aliases.part.77() { tokio-runtime-w-11886 [002] 193385.057882: funcgraph_entry: 3.959 us | mutex_lock(); tokio-runtime-w-11886 [002] 193385.057893: funcgraph_entry: 3.000 us | purge_fragmented_blocks_allcpus(); tokio-runtime-w-11886 [002] 193385.057900: funcgraph_entry: 2.791 us | __purge_vmap_area_lazy(); tokio-runtime-w-11886 [002] 193385.057907: funcgraph_entry: 2.709 us | mutex_unlock(); tokio-runtime-w-11886 [002] 193385.057913: funcgraph_exit: + 33.708 us | } tokio-runtime-w-11886 [002] 193385.057915: funcgraph_exit: + 43.000 us | } tokio-runtime-w-11886 [002] 193385.057922: funcgraph_entry: | __change_memory_common() { tokio-runtime-w-11886 [002] 193385.057925: funcgraph_entry: | apply_to_page_range() { tokio-runtime-w-11886 [002] 193385.057930: funcgraph_entry: | __apply_to_page_range() { tokio-runtime-w-11886 [002] 193385.057933: funcgraph_entry: 4.292 us | pud_huge(); tokio-runtime-w-11886 [002] 193385.057945: funcgraph_entry: 8.750 us | pmd_huge(); tokio-runtime-w-11886 [002] 193385.057956: funcgraph_entry: 3.958 us | change_page_range(); tokio-runtime-w-11886 [002] 193385.058037: funcgraph_exit: + 32.083 us | } tokio-runtime-w-11886 [002] 193385.058089: funcgraph_entry: 7.667 us | irq_enter_rcu(); tokio-runtime-w-11886 [002] 193385.058233: funcgraph_exit: ! 308.041 us | } tokio-runtime-w-11886 [002] 193385.058239: funcgraph_exit: ! 316.709 us | } tokio-runtime-w-11886 [002] 193385.058247: funcgraph_exit: ! 400.417 us | } tokio-runtime-w-11886 [002] 193385.058255: funcgraph_exit: ! 415.000 us | } tokio-runtime-w-11886 [002] 193385.058555: funcgraph_entry: 8.250 us | irq_enter_rcu(); tokio-runtime-w-11886 [002] 193385.058958: funcgraph_entry: | kallsyms_lookup_size_offset() { tokio-runtime-w-11886 [002] 193385.058974: funcgraph_entry: + 36.333 us | get_symbol_pos(); tokio-runtime-w-11886 [002] 193385.059017: funcgraph_exit: + 59.750 us | } tokio-runtime-w-11886 [002] 193385.059043: funcgraph_entry: | kfree() { tokio-runtime-w-11886 [002] 193385.059057: funcgraph_entry: 3.000 us | __kmem_cache_free(); tokio-runtime-w-11886 [002] 193385.059065: funcgraph_exit: + 22.833 us | } tokio-runtime-w-11886 [002] 193385.059073: funcgraph_exit: # 2644.708 us | } tokio-runtime-w-11886 [002] 193385.059079: funcgraph_exit: # 2706.292 us | } tokio-runtime-w-11886 [002] 193385.059095: funcgraph_entry: 2.792 us | mutex_unlock(); tokio-runtime-w-11886 [002] 193385.059101: funcgraph_exit: # 2870.416 us | } 这次程序已经通过了arch_prepare_bpf_trampoline、set_memory_ro和set_memory_x,我们看到的最后一个函数是kallsyms_lookup_size_offset。 正如我们在kernel/bpf/trampoline.c中的bpf_trampoline_update函数中所看到的,这里并没有明确调用kallsyms_lookup_size_offset: static int bpf_trampoline_update(struct bpf_trampoline *tr, bool lock_direct_mutex) { // ... OTHER CODE ... #ifdef CONFIG_DYNAMIC_FTRACE_WITH_DIRECT_CALLS again: if ((tr->flags & BPF_TRAMP_F_SHARE_IPMODIFY) && (tr->flags & BPF_TRAMP_F_CALL_ORIG)) tr->flags |= BPF_TRAMP_F_ORIG_STACK; #endif err = arch_prepare_bpf_trampoline(im, im->image, im->image + PAGE_SIZE, &tr->func.model, tr->flags, tlinks, tr->func.addr); if (err < 0) goto out; set_memory_ro((long)im->image, 1); set_memory_x((long)im->image, 1); WARN_ON(tr->cur_image && tr->selector == 0); WARN_ON(!tr->cur_image && tr->selector); if (tr->cur_image) /* progs already running at this address */ err = modify_fentry(tr, tr->cur_image->image, im->image, lock_direct_mutex); else /* first time registering */ err = register_fentry(tr, im->image); #ifdef CONFIG_DYNAMIC_FTRACE_WITH_DIRECT_CALLS if (err == -EAGAIN) { /* -EAGAIN from bpf_tramp_ftrace_ops_func. Now * BPF_TRAMP_F_SHARE_IPMODIFY is set, we can generate the * trampoline again, and retry register. */ /* reset fops->func and fops->trampoline for re-register */ tr->fops->func = NULL; tr->fops->trampoline = 0; /* reset im->image memory attr for arch_prepare_bpf_trampoline */ set_memory_nx((long)im->image, 1); set_memory_rw((long)im->image, 1); goto again; } #endif if (err) goto out; if (tr->cur_image) bpf_tramp_image_put(tr->cur_image); tr->cur_image = im; tr->selector++; out: /* If any error happens, restore previous flags */ if (err) tr->flags = orig_flags; kfree(tlinks); return err; } ```shell > **注意:** <code>bpf_trampoline_update</code>的实现与之前的内核5.15稍有不同。 <code>kallsyms_lookup_size_offset</code>的调用被隐藏在另一个函数内部。我们在函数图中看不到它,因为编译器将其内联了。 看起来<code>kallsyms_lookup_size_offset</code>是由<code>ftrace_location</code>调用的: ```c unsigned long ftrace_location(unsigned long ip) { struct dyn_ftrace *rec; unsigned long offset; unsigned long size; rec = lookup_rec(ip, ip); if (!rec) { if (!kallsyms_lookup_size_offset(ip, &size, &offset)) goto out; /* map sym+0 to __fentry__ */ if (!offset) rec = lookup_rec(ip, ip + size - 1); } if (rec) return rec->ip; out: return 0; } ftrace_location被register_fentry调用,而register_fentry在调用ftrace_location之后,在struct bpf_trampoline *tr的fops字段上包含了一次检查。 /* first time registering */ static int register_fentry(struct bpf_trampoline *tr, void *new_addr) { void *ip = tr->func.addr; unsigned long faddr; int ret; faddr = ftrace_location((unsigned long)ip); if (faddr) { if (!tr->fops) return -ENOTSUPP; tr->func.ftrace_managed = true; } if (bpf_trampoline_module_get(tr)) return -ENOENT; if (tr->func.ftrace_managed) { ftrace_set_filter_ip(tr->fops, (unsigned long)ip, 0, 1); ret = register_ftrace_direct_multi(tr->fops, (long)new_addr); } else { ret = bpf_arch_text_poke(ip, BPF_MOD_CALL, NULL, new_addr); } if (ret) bpf_trampoline_module_put(tr); return ret; } 确实,如果tr->fops为false,该函数将返回错误-ENOTSUPP。 让我们找出tr->fops是在哪里初始化的。 如果我们是正确的,那么创建trampoline的地方应该在bpf_trampoline_lookup函数内部。 static struct bpf_trampoline *bpf_trampoline_lookup(u64 key) { struct bpf_trampoline *tr; struct hlist_head *head; int i; mutex_lock(&trampoline_mutex); head = &trampoline_table[hash_64(key, TRAMPOLINE_HASH_BITS)]; hlist_for_each_entry(tr, head, hlist) { if (tr->key == key) { refcount_inc(&tr->refcnt); goto out; } } tr = kzalloc(sizeof(*tr), GFP_KERNEL); if (!tr) goto out; #ifdef CONFIG_DYNAMIC_FTRACE_WITH_DIRECT_CALLS tr->fops = kzalloc(sizeof(struct ftrace_ops), GFP_KERNEL); if (!tr->fops) { kfree(tr); tr = NULL; goto out; } tr->fops->private = tr; tr->fops->ops_func = bpf_tramp_ftrace_ops_func; #endif tr->key = key; INIT_HLIST_NODE(&tr->hlist); hlist_add_head(&tr->hlist, head); refcount_set(&tr->refcnt, 1); mutex_init(&tr->mutex); for (i = 0; i < BPF_TRAMP_MAX; i++) INIT_HLIST_HEAD(&tr->progs_hlist[i]); out: mutex_unlock(&trampoline_mutex); return tr; } 在分配之后,只有在出现CONFIG_DYNAMIC_FTRACE_WITH_DIRECT_CALLS标志时,才会填充trampoline的fops字段。这个标志依赖于HAVE_CONFIG_DYNAMIC_FTRACE_WITH_DIRECT_CALLS标志,而这个标志在aarch64上不存在。 结论 当前情况下,由于缺少_ftrace直接调用_功能,无法在 aarch64 上使用 BPF LSM 。幸运的是,当前的 mainline 分支已经合并了一个 补丁 ,该补丁将在 aarch64 上启用LSMs(以及其他功能)。 预计这些变化将会在下一个6.4版的Linux内核中发布。 2024-01-26 1 0
美团RASP大规模研发部署实践总结 背景 RASP是Runtime Application Self-Protection(运行时应用自我保护)的缩写,是一种应用程序安全技术。RASP 技术能够在应用程序运行时检测并阻止应用级别的攻击。随着云计算和大数据的发展,应用程序安全越来越受到重视。RASP 技术作为一种新型的安全防护手段,正在逐渐被业界接受并广泛应用。其中Java RASP 是一种针对 Java 应用程序的 RASP 技术。通过在 Java 虚拟机(JVM)级别进行监控和防护,能够有效防止对 Java 应用程序的攻击。 RASP建设挑战 在业界,RASP的部署形式一般有agentmain、premain两种方式,二者各有优劣。适合不同的业务场景,以及安全需求。 agentmain:业务无需改动,无需重启,热插拔,动态升级。有性能抖动,业务有感知。 premain:需要改动,需要重启,前置注入,升级需要重启。无性能抖动,业务无感知。 美团的RASP建设时,大部分业务都已经在线上运营,而且有多个发布平台,没有提供一个统一的方式来更改启动参数,也就是说无法通过premain方式是实现快速部署。为了抓住主要矛盾,快速解决大部分风险问题,我们选择了agentmain方式。 业务场景复杂 技术方案的设计,依赖于业务形态。美团内部的业务服务中,Java语言占比80%以上,是主要的风险所在。2010年至今,有特别复杂的业务部署形态、业务依赖环境、繁多的JDK等等,这些都是RASP技术方案的挑战。 业务部署方式:物理机、宿主机、富容器、轻容器等; 发布环境:由于历史原因公司已知的发布系统至少有3个; Web中间件:Spring Boot、Jetty、Tomcat、WebLogic、自研框架等; JDK版本:Oracle、OpenJDK、 MJDK、Kona、Dragonwell、毕昇等; 进程数量:单个主机上进程数量和生命周期差异大,有的几千个进程,生命周期有分钟级、年级等; 问题的拆解思路依旧是抓住主要矛盾,以JDK版本为例,各个版本JDK的主机占比如下图1; 图1 公司JDK版本分布占比 业务目标确定后,解决方案同样具体到某一类的JDK上。同样,在发布环境、Web中间件的差异上,对RASP也有了更多的兼容要求。 对业务性能影响大 agentmain的动态注入机制,对JVM的影响是不可规避的。影响大小可以从与其他安全防护产品的部署位置看出,下图2是常见的基础安全防护产品:WAF、HIDS和RASP,他们与业务的隔离方式有以下几类: 主机隔离 进程(容器)隔离 无隔离(或者类加载器隔离) 图2 主机安全防护产品与业务的隔离等级 与其他的安全产品相比,如网络应用防火墙(WAF)和主机入侵检测系统(HIDS),RASP与业务部署在同一Java虚拟机(JVM),其隔离级别是最低的。这就意味着,当RASP自身出现BUG或者与业务不兼容时,对业务造成直接影响。RASP 一旦出现故障那至少是S4级别(核心功能受影如资损、客诉,且预判5分钟无法恢复) 。从业务指标上分为cpu和执行耗时,执行耗时方面主要是对服务的TP9999影响较大,而CPU方面出现cpu.busy指标抖动情况。对于业务的指标影响,有以下几种: 运行时注入cpu.busy指标突增 下图3为特殊情况下运行时注入cpu.busy指标抖动情况,在RASP注入时间内(CPU分钟级别采样),Java 进程的CPU从0%飙升到50%,然后又恢复。如果RASP注入之前Java进程的CPU已经很高了,注入时CPU会直接打满(注入前后10分钟)。 图3 运行时注入cpu.busy指标抖动情况 运行时注入TP9999指标 下图4为运行时注入TP9999指标抖动情况。单机维度,注入时TP9999从5ms飙升到1000ms,大幅度增加,TP9999出现明显的尖刺,对响应时间敏感的服务影响特别大。 图4 运行时注入TP9999指标抖动情况 启动时性能差与检测逻辑执行耗时长 在RASP启动时,大量请求进入到检测流程中,此时RASP检测代码没有完成预热,检测方法处于字节码解释运行模式,执行效率低,从而导致启动时TP线高。如果正常的请求检测耗时过长,将严重影响业务的TP线,甚至导致请求超时。 在RASP运行过程中,因为检测引擎执行耗时长也会导致业务超时。 升级变更难 由于原生Java Agent的限制问题,JVM一旦加载了Agent,就无法进行更新,只能等待JVM重启。 图5 运行时Java Agent的实现原理与升级过程 图5左边的图展示了一个典型的运行时Java Agent的实现原理。在这个过程中,守护进程(这里指主动发起Attach的进程RASP Daemon)会attach到目标JVM上,然后RASP Agent的jar包会被JVM的AppClassLoader加载,接着Agent就会初始化并开始运行。然而,由于JVM类加载机制的限制,同一个类(Agent入口类)无法被AppClassLoader加载器加载两次。使用新的Agent jar包重新attach,即使attach成功,也不会加载新的类。因此想要增加新的功能或者进行bug修复,就必须等待业务进程重启后才能实现。 这也就是说,RASP功能的升级完全依赖于业务进程的重启时机。然而,我们发现线上有些业务,如大数据服务的核心节点,其重启时间可能长达半年甚至更长时间,这就使得RASP的功能升级过程变得异常漫长。由于服务长期未重启,RASP版本无法进行更新。影响主要有2个方面,一方面长期未重启服务的RASP版本低于最新版本,RASP Daemon需要兼容多种RASP Agent版本,这无疑提升了代码工程向下兼容的工作量和稳定性;另一方面,未重启的服务最新的hook点无法生效,也带来一定的安全风险。 热更新是强诉求 在美团内部,安全部门需要不对业务有过多打扰的前提下保障业务安全运行。大规模重启服务风险高,不具备可实施性。如果遇到紧急漏洞或者重大bug时,这种升级难的问题尤为突出。升级难的问题是RASP在部署中遇到的第一个重大问题。 监控难 当JVM加载Java Agent后,由于其运行在业务的同一层面,必然会对业务产生一定的影响。这些影响可能包括CPU使用率飙高、TP9999线的波动,甚至可能出现故障如内存泄漏、磁盘打满、核心转储(core dump)、触发JDK Bug、线程死锁、GC时间变长等等各种问题。业务反馈的线上各类问题的占比如下图6所示。 图6 RASP各类故障占比 由于RASP接入对用户无感知,一旦出现这些问题,业务方定位问题的源头往往耗费大量时间。业务需要对业务状态日志、GC日志、系统变更日志等进行详细的排查,以确定问题的根因。在实际的运行过程中,往往是业务最先反馈RASP影响,而RASP不能做到对故障及时感知与处理。 RASP架构介绍 美团 RASP 利用 Java agent 和instrumentation技术,通过 ASM 修改类字节码,实时分析检测命令执行、文件访问、反序列化、JNDI、SQL注入等入侵行为。它最初是从开源项目btrace 演化而来,后使用Golang重写了btrace的进程注入的功能,即架构中的 RASP Daemon 部分,在 Java Agent 端也参考了一些开源项目和公司内部的性能诊断工具。经过多年的迭代,RASP 逐渐形成目前的架构。 通过RASP管理端进行主机维度的配置下发,将最新配置更新应用到 RASP Daemon。日志收集和jar包下载使用公司基础组件,通过这些组件的协同工作,实现对 RASP 部署过程的管理,包括支持灰度发布、配置回滚、降级和一键关闭操作。下图7为 RASP 的配置分发流程。 图7 RASP的配置分发流程 解决方案 灰度部署方式和复杂场景的兼容 RASP 启动方式 传统的RASP直接修改JVM启动参数增加RASP的Java Agent参数,即premain方式。而美团的RASP在最初只支持运行注入agentmain方式,不支持premain。原因主要是下面的2个方面: 在RASP项目建立时,公司的机器节点数量已经有几十万规模了,业务先行,安全补位。已经面临风险,需要尽快实现安全能力覆盖。 早期公司内部服务发布平台不完善,有多个发布系统,并且每个业务线的发布脚本不统一,统一控制的力度弱。 综合业务现状与安全诉求,比较符合技术选型的是agentmain机制。无需业务改动,也不依赖统一的代码发布平台,做到安全部门可控的能力覆盖。 经过多年部署,RASP已经覆盖大部分业务,具备相应安全能力。但也逐步遇到业务抱怨RASP注入带来的性能抖动问题。随着公司基础组件建设,也逐步统一了代码发布系统,在JAVA类服务的管控上有了统一的控制入口。同时,IDC内服务形态逐渐从VM虚拟机演化到容器,RASP的服务环境也与以往不一样。 当下主要矛盾发生变化,业务形态发生变化,支持premain的技术方案迫在眉睫。RASP联合服务发布与镜像团队在拉起服务之前将RASP的Java Agent以环境变量的方式设置到服务启动脚本的上下文中。下面为部署脚本中关于RASP环境变量的设置片段。 // 前置检查... // 增加环境变量 if [[ $RASP_SWITCH=="ON" ]];then JAVA_TOOL_OPTIONS="$JAVA_TOOL_OPTIONS -javaagent:rasp-premain.jar" && export JAVA_TOOL_OPTIONS fi // 启动Java进程... 配置分发方案 在 RASP 升级新版本时,为尽可能地提高稳定性,需要按照一定策略进行灰度升级。 公司内部分为测试和生产等多种环境,并且测试环境服务器数量为万级别,RASP 需先在线下环境稳定运行足够时候后再开始线上环境灰度; 服务按照重要性(或者环境复杂性)从低到高划分为普通服务、重要服务、高优服务3个类别,依次进行。 每一个服务需要再按照主机数量的百分比进行灰度,一个服务下的主机不能同时进行 RASP 的升级,需按照 10%、30%、50%、100% 的比例灰度。 Web/JDK版本识别与准入 RASP Daemon(golang语言) 通过内核进程事件,感知新进程。再识别进程的cmdLine、JDK、Tomcat、Jetty、Spring Boot等的关键jar包,解析出JDK版本、Web类型和版本。对于已经兼容的服务可以开启注入,对于无法识别或者与RASP不兼容的服务关闭注入(es、jetty等个别版本),最大程度的减少对业务的影响。 组件的兼容性 JDK 兼容性:美团RASP除了使用ASM包之外基本上不使用第三方组件,降低供应链攻击,同时减少对不同版本JDK的专有特性依赖,对于JDK的代码也尽可能的本地化到RASP工程中,屏蔽JDK的版本差异性。 Java Agent 兼容性:公司有多种Java Agent 包括性能诊断,安全扫描、动态调试、流量录制、热部署、链路追踪等约十多种,这些工具实现原理都是基于Instrument。 冲突主要在还是在字节码修改上,例如RASP与jdwp的兼容上,最初版本的RASP在业务类中增加方法数量,当用户开启远程debug时,本地代码的方法数量与远程不一样,导致JVM崩溃。Java Agent应该遵循的规范: 字节码的修改应该遵循下面的基本原则:不允许新增、修改和删除成员变量 ;不允许新增和删除方法 ;不允许修改方法签名(来源于:Java 字节码规范); Java Agent的jar包应该采用自定义类加载加载,依赖包名称前缀替换等方式,避免与其他Java Agent和业务依赖的冲突; 与其他Java Agent约定,在类查找遍历修改时排除其他的Java Agent的包名称,避免相互引用; 对于热部署等Java Agent,由于它不遵循字节码修改的基本规范,很遗憾,目前无法兼容,只能排除关闭注入; 2.2 RASP的运行时注入与更新 运行时注入方式解决了RASP的首次注入不依赖业务重启服务的问题,但是随着部署场景的增加,不可避免的要对RASP进行更新迭代,如何升级成为一个让人头疼的问题。于是更新也不依赖业务重启,成为一个需要解决的最大问题。 插件热更新是一项具有挑战性的技术,也是RASP建设初期要求具备的核心特征之一。由于美团拥有上百万个Java服务节点,一般的Java Agent安装和升级都需要重启Java进程,对于如此庞大规模的服务来说,这并非易事。在超大规模下,如果依赖业务重新发布的方式来使RASP生效,需要等待所有的服务重启一遍。RASP项目没有权限重启业务。因此,对于RASP来说,插件热更新是至关重要的。 在最初的版本中,当RASP注入到业务中后,如果需要更新功能(如修改策略或hook点),仍然需要重新启动Java进程。如果业务不重启,之前版本的RASP会残留在进程中无法卸载,而新版本需要兼容这些无法卸载的部分。这导致线上存在多个不同版本的RASP,不同版本之间的兼容性几乎无法实现,这种方式是行不通的。 因此, RASP借鉴了Tomcat的类加载器架构,将功能分为两类:第一类是需要频繁迭代的功能,如hook点、资源监控、检测引擎、通信等;第二类是几乎不需要改动的部分,如插件加载和初始化部分。将第一类功能抽取出来,形成一个单独的插件包(RASP Plugin),插件包由自定义类加载器加载,使得这部分具备运行时更新的能力。而RASP Agent引导包仅保留几个类,负责初始化插件jar包。下图8展示了拆分前后的对比: 图8 mt-rasp jar包拆分前后对比 对于拆分后的架构,首次注入 RASP Agent 加载V1.0的插件,在需要对插件进行更新时,清除RASP PluginV1.0对象的引用和PluginClassLoader对象,然后创建新的PluginClassLoader实例重新加载并初始化V1.1版本插件,从而实现插件的卸载与热更新。上面拆分方案实现依靠自定义RASP类加载器,RASP的类加载器层次结构(agentmain)如下图9所示: 图9 RASP的类加载器层次结构 从顶层类加载器开始依次说明RASP包的功能和所属的类加载器。 rasp-boot.jar:定义全局变量,能够被所有类访问到,使用BootstrapClasLoader加载; rasp-agent.jar :标准的Java Agent 入口类,定义了agentmain/premain 等Agent初始方法、加载plugin并初始化,使用AppClassLoader加载; rasp-plugin.jar :RASP核心实现,包括hook点、检测逻辑、资源监控等功能,使用自定义类加载器RaspClassLoader加载; Script.class :定义检测逻辑,父加载器为RaspClassLoader,使得脚本类能够访问rasp-plugin.jar中的类,使用自定义类加载器ScriptClassLoader加载,并且脚本在磁盘加密在运行时解密。 premain & agentmain 两种方式兼顾 agentmain和premain方是Java Agent的两种启动方式,agentmain在Java进程启动后加载,而premain在Java进程启动前加载。由于启动时机不一样,带来的差异主要有agentmain 更新加载更加灵活,但是字节码修改时存在性能问题,特别是对性能比较敏感的服务;而premain需要将javaagent参数加入到JVM启动命令行中,完全依赖业务启动,不太灵活,但是性能上比较稳定。美团RASP采用agentmain与premain结合方式,平衡灵活性与性能。原则上premain逻辑尽可能的简单,避免频繁的迭代与升级。 premain 一期方案 RASP在加载时,Java进程的CPU会短暂的升高甚至打满,并且CPU核数越少,升高越明显持续时间越长。根因是Java Agent首次加载时会触发JVM中的code cache区域清零机制(可以认为是JDK的bug),大量热点代码的编译导致JIT编译线程将CPU打满,并且这种现象在CPU核数低于4核时表现尤为明显。 Manifest-Version: 1.0 Premain-Class: com.meituan.rasp.agent.RaspAgent Agent-Class: com.meituan.rasp.agent.RaspAgent Can-Redefine-Classes: true Can-Retransform-Classes: true Can-Set-Native-Method-Prefix: true 为了解决运行时CPU飙高问题,我们引入空的premain包(premain v1.0)(仅开启上面的字节码转换的开关Can-Redefine-Classes,无任何逻辑,也不修改字节码),在应用启动前加载,该方案取得较大优化效果。因为无任何代码,代码兼容性风险极小(并不是没有),因此能快速上线解决CPU飙高问题。以某个业务的主机为例子,在优化前后的cpu.busy指标如下图10所示(注入前后10分钟)。 图10 cpu.busy指标优化前后对比 图10中红色为优化前的cpu.busy指标,优化前即使注入前系统负载很低(4核8G,cpu.busy <2%),注入瞬间CPU依然飙升很高(28%);蓝色为优化后的cpu.busy指标,优化后cpu.busy曲线较平滑,无明显尖刺。 premain 二期方案 采用premain一期方案的原因是代码足够简单,几乎没有兼容性问题,因此能够快速大规模部署解决棘手的cpu抖动问题,上线效果较好。但是大部分服务虽然CPU不飙高了,但是还有少部分的服务TP9999指标依然影响较大。 修改字节码TP9999线升高分析 premain一期方案主要用来快速解决cpu.busy抖动问题,但是对于性能比较敏感(如tp9999 < 50ms)的业务,运行时字节码修改不可避免的造成STW,从而导致TP9999 线升高。因为字节码修改时需要进入JVM的safepoint,执行字节码转换的方法VM_RedefineClasses::doit会导致应用短暂地暂停响应,这部分代码执行慢就会影响应用TP9999。大批量修改字节码测得火焰图如下图11所示。 图11 批量字节码转换时的Java进程火焰图 从火焰图11看出,RedefineClasses 耗时主要在VM_RedefineClasses::AdjustCpoolCacheAndVtable::do_klass ,hotspot JDK官方也有类似的issue。转换一个类的主要耗时在redefine_single_class方法,初步测试耗时占比在40%~80% 之间,并且一次转换类越多,占STW总耗时越大。 类转换STW时间与服务负载(QPS)关系 在同一服务(硬件配置8核8G)测试了修改类的个数、服务负载和STW时间的关系如下图12所示: 图12 类转换STW时间与服务QPS、转换类数量的关系 从上面数据可以对比看出: 业务请求QPS为0时,STW时间并不为0; QPS为20时,一次转换的类越多,单个类的STW耗时越长; 转换相同数量的类,随着QPS的增加,STW时间有增加,但是不明显; 从上面的分析可以看出,修改字节码无法避免的产生STW(当然,优化这部分JDK代码理论上是可以实现的,但是技术难度较高,短期内无法解决),因此只能从规避的角度出发来解决。原则上只要保证字节码修改时没有请求即可。 一种可行的方案是将字节码转换的逻辑前移到JVM启动前(即业务没有流量或者主动摘除流量),并且尽量避免有请求时大批量的回滚/修改字节码,能够在一定程度上避开或者缓解STW影响业务请求响应时间。 premain修改字节码 对于高频率调用的方法如http body参数读取、sql.execute等,使用premain修改字节码插入RASP检测逻辑,premain agent做到轻量级。对RASP的架构做出相应修改,新增rasp-premain.jar,让服务启动前进行加载并初始化,将字节码的转换逻辑前置到启动时,如下图13所示,蓝色jar包为新增的rasp-premain.jar。 图13 RASP类加载器增加premain agent 为了最大程度复用之前的系统架构,premain加载后虽然字节码已经被转换,但 RASP的功能在逻辑上是关闭的,需要等到 agentmain 注入之后打开检测开关。premain 只做字节码转换,没有日志和通信等功能,不能单独工作。如图14所示,优化前后TP9999指标有较明显改善。 图14 优化前后注入时TP9999指标 运行时性能优化与整体指标 rasp加载之后的流量预热 在RASP的流量控制层增加对流量的计数,RASP初次接入流量时控制接入流量的比例(如1%),使得业务业务流量能够预热RASP检测逻辑,预热时间或者次数达到设定的阈值后,再开启100%的流量检测。 软降级与逻辑开关 业务负载较高的场景(CPU飙高、hook逻辑执行严重超时等),为了避免RASP检测逻辑加剧性能恶化,RASP采样软降级措施,关闭对应hook类的逻辑开关,使得部分流量不执行检测逻辑。如果性能进一步恶化,RASP运行模式降级为观察上报模式,待系统资源检恢复正常过后,资源监测通过后自动恢复到检测阻断模式。 延时回滚字节码 RASP更新插件代码时,需要将plugin的全部对象置空,否则会有内存泄漏问题,特别是元空间的内存泄漏,将导致业务将运行越来越慢,直到停止运行。从前面的STW时间结论来看,运行时的字节码回滚(和修改机制相同)也会产生STW,因此RASP将hook代码的逻辑开关关闭后,字节码依然留在业务类中,在清理完各种对象引用关系后,依然能够卸载plugin插件。 监控体系建设 全局维度的监控指标: 主机注入覆盖率大盘; coredump总数; 高峰期字节码的修改数量; 熔断超时数量和比例; 单机维度指标:从业务层面到系统层面如下(列举部分) 业务层面:检测引擎执行耗时、TP9999、请求出错率等 JVM层面: 堆内存、元空间/永久代、线程死锁、插件加载次数限制、GC、STW耗时、字节码转换等 进程层面:Java进程CPU、内存、coredump、守护进程状态等 系统维度:系统CPU、系统内存、系统磁盘空间、网络等 图15 RASP监控的指标分布 系统指标和进程指标对于Golang来说很容易获取,相关api较多。这里仅以JVM指标元空间使用率(MetaSpace)的检测为例子说明。RASP Daemon 执行attach获取目前JVM的最大元空间(MaxMetaSpaceSize)指标,然后读取 /tmp/hsperfdata_${user}/pid 文件解析元空间的占用(usedMetaspaceSize参数在jvm里面是sun.gc.metaspace.used),计算出元空间的占用比例和剩余空间,当剩余空间不足时,禁止RASP Agent注入,防止RASP成为压垮业务的最后一根稻草。 性能影响 测试配置: 8核/8G/150G 压力:QPS梯度100,持续120s,稳定施压 120s cpu.busy 表1 注入前后的cpu.busy指标 基准数据(不加载RASP) 注入数据(加载RASP) CPU指标增量值 QPS=20 3.47% 4.18% 0.71% QPS=100 11.70% 11.76% 0.06% QPS=200 20.95% 21.05% 0.15% QPS=300 32.12% 32.78% 0.66% QPS=400 41.23% 44.2% 2.97% QPS=500 52.78% 56.5% 3.73% 最大QPS 620 587.8 - 拟合方程 拟合方程:y = 0.103x + 1.203 拟合度:0.999 拟合方程:y = 0.109x + 0.827拟合度:0.998 cpu.busy 绝对值增加: 0.06%~3.73%,整体性能与开源的RASP相当 堆内存增加 QPS超过350时系统cpu达到35%,触发弹性扩容,QPS压测到350可以测出最大内存损耗。 表2 注入前后的内存增加值 最小值 平均值 最大值 基准(QPS=350) 422.38MB 638.34MB 3.10GB 注入(QPS=350) 457.69MB 821.59MB 3.30GB 差值 32MB 183MB 0.2GB 注入前后对比,压测到系统弹性扩容的最大QPS,最大堆内存增加约200M,整体性能与开源的RASP相当 元空间增加 元空间/永久代增加2MB,优于开源RASP产品 请求耗时 当前请求耗时控制在5ms内,优于开源RASP产品 漏洞检测 支持的漏洞类型 经过近多年的研发迭代,目前具备的漏洞检测类型如下,基本覆盖常见漏洞(部分):命令执行 (支持native方法)、SQL注入、文件访问、反序列化攻击、JNDI、表达式等等。 实时检测与阻断 不同语言实现的脚本性能比较 开源方案中采用了JavaScript引擎作为实现方式,JS脚本可以被Java、php和c++等各种语言兼容,具备较强的通用性。但是经过测试,与原生Java相比,这些方案在性能上存在较大的差距。尽管JavaScript引擎具有不同语言通用性的大优势,但在执行性能方面并不满足高性能场景下RASP的需求。在美团,相比于性能,检测引擎的语言通用性并不是最重要的考虑因素。下面简单对比一下JavaScript和Java实现的检测引擎的性能。因为检测脚本主要涉及字符串的各种操作,我们选择了字符串累加的for循环作为测试场景。 // java c+='c' // javascript c=c+'c' 经过测试,我们发现Java在执行这种字符串操作的性能方面表现更好。Java作为一种编译型语言,具有较高的执行效率和优化能力。它可以通过使用StringBuilder等高效的字符串操作类来提高性能。相比之下,JavaScript作为一种解释型语言,执行效率相对较低。因此,在高性能场景下,使用Java实现的检测引擎往往能够更好地满足需求。尽管JavaScript引擎具有通用性,但在性能要求较高的场景下,选择使用Java实现的原生检测引擎更为合适。 表3 10万量级的for循环中跑出结果如下(单位ms) javascript java 平均执行耗时 585 6.5 可以看出Java语言实现的检测引擎,性能上具备优越性。美团RASP使用Java语言构建检测引擎,能够满足性能上的需求。 检测脚本的实现 在RASP Plugin中定义了检测脚本需要实现的接口,脚本的实现类由RASP Server下载到磁盘上;RASP Agent定时检测脚本文件是否更新,如果脚本更新,使用新的类加载器加载磁盘上的class文件,并创建实例。 阻断与热修复 在RASP中,通常会在hook方法的执行之前(before)、返回(return)和抛出异常处(throw)增加检测逻辑。RASP通过使用ASM字节码框架,在方法的before、return和throw处织入检测逻辑的字节码(下图16黄色框)。 图16 RASP阻断热修复控制流程 这里以在方法返回之前增加hook逻辑为例子说明阻断/热修复的流程: 字节码插桩:使用ASM工具识别方法中的返回指令如(return、areturn等),在返回指令之前插入RASP的检测方法的字节码,使用instrument的restransform api将修改后的字节码替换原来的字节码。 运行时检测:当检测引擎返回阻断异常对象时,方法的异常处理抛出阻断异常,终止方法的执行(上图16红色箭头的流程);当检测引擎返回对象时,提前返回指定的对象,修改返回的返回值(上图16中蓝色箭头的流程);返回Null,表示既不阻断也不返回对象(上图16绿色箭头的流程),不改变当前方法的执行流程和返回对象。 热修复与阻断的区别在于热修复返回的是一个对象,这个对象是修复后的正确的对象。 成果 美团RASP经过多年的建设,在覆盖对象、部署方式、性能优化、兼容性和安全策略等多个方面逐步迭代,现在已覆盖绝大多数Java服务,支持众多web容器部署,基本覆盖常见的安全漏洞,整体覆盖率上达到了较高水位,并且多次检测出海量的漏洞攻击,成为美团IDC基础安全纵深防御体系中最重要的安全能力。 总结 本文主要介绍了美团RASP在研发过程中遇到的问题和解决方案。首先介绍了RASP的痛点问题,包括业务场景复杂、升级变更难、对业务性能影响大和缺少监控等。对于RASP的升级问题,引入了插件热更新的技术,可以在不重启Java进程的情况下,即时地更新RASP的功能。为了降低对业务性能的影响,介绍了采取的优化措施,包括低峰期注入、启动时流量预热、软降级与逻辑开关以及插件卸载时不回滚字节码等关键技术。然后介绍了RASP的监控体系建设,包括监控指标的定义和收集。最后介绍了RASP的性能与灰度策略,通过对性能损耗的测试和分析,可以看出RASP对CPU和QPS的影响较小。在灰度策略方面,RASP结合了业务形态,特性影响等,选择合适的验证机制和测试方法。 后续规划: 新型容器形态支持:美团IDC形态中,逐步从VM、富容器过度到轻容器,未来轻容器的会快速增加,RASP的管控机制、容器隔离机制,都是未来RASP的挑战; 低打扰无感接入:宿主业务的低打扰,注入性能影响,小众场景的覆盖,依旧是RASP的核心重点,让业务无感、自动、默认接入RASP,提升整体IDC防御水位; 管控、监控自动化:管控端的配置下发依赖链路较多、流程较长,配置变更成本风险高,优化为更高效、更实时、更准确的机制; 本文作者 许乐 、孙绥 、石东华、陈驰、郁丛祥、卢世宇等来自于美团信息安全部。 招聘 范围包括不限于HIDS、RASP、EDR、零信任产品等基础安全方向研发 可直接在本公众号内发送简历。 岗位职责 负责美团应用程序自我防护系统的开发,通过Java字节码技术实现Java应用程序的防护;工程能力做到百万级别的Java应用覆盖,保障稳定性和性能;RASP/IAST等安全产品技术预研; 岗位要求 具备计算机科学、信息安全或相关领域的本科及以上学历; 熟练掌握 Java、Python、Go 等编程语言中的一项或多项; 至少能够精通一个Java web框架的原理,有一定的字节码技术的研发使用经验; 有过中间件开发经验,大规模覆盖应用者优先; 具备出色的分析问题和解决问题的能力,良好的团队协作和沟通能力; 具备良好的学习总结能力,并乐于分享; 优先条件 有过JVM技术研究经验; 有过RASP/IAST/APM开发经验; 岗位亮点 技术本身的难度; 挑战工业界的工程能力 2024-01-16 0 0
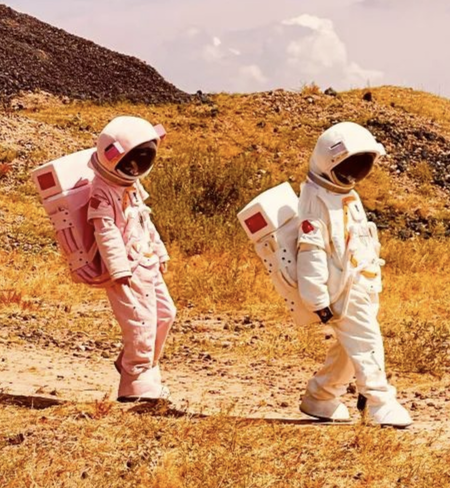
手机镜头下的2023年 by CFC4N 去年的这个时候,你在干什么,你还记得吗?半年前呢?上个月呢?恍惚之间,一年又过去了。那时的记忆还清晰吗? 笔者挑选了2023年自己手机拍摄的一些照片,分享给大家。 设备与软件 摄影设备:iPhone 12 Pro Max 调色软件:iPhone自带照片软件 记录瞬间 一月 江苏苏州 上方山 春节期间,跟家人游玩。时间太久,心情记不清了。 二月 光大安石中心 节后,跟许同学到公司另外一个办公点拜访专家,交流RASP建设事宜。等待老友高同学时抓拍。 三月 慕田裕长城 去北京出差,周末跟老友F哥、韩同学到郊区游玩。也是我出差北京五年来,首次离开望京。 七月 四川省阿坝州 暑假,带老婆孩子去旅游。对四川有种莫名的情怀,人生为数不多的几次旅游,都是成都。期间去了九寨沟、黄龙景区,从此之后,对自然风光景点有了更深刻的认识。从此,再也没有能入法眼的风景。 九寨沟长海 九寨沟镜海 黄龙五彩池 八月 上海中心大厦 暑假,同村玩伴多年不见,从苏州来上海游玩,我做导游,带他们登上了东方明珠电视塔。这也是我来上海十多年的首次登塔。 八月 公园野鸭 公园草坪上的躺椅下看到几只乘凉的鸭子,每天接触的人多了,胆子比较大,对人类也比较温顺,可以近距离交流,一身洁白的羽毛特别漂亮。 九月 乌兰察布 还是出差,项目建设达成一个阶段,与团队小伙伴去团建。选择了内蒙古乌兰察布市的火山地质公园,十几个人,开了三辆车,周五晚上从北京触发,到张家口休息一晚,第二天直接开到。 从来没见过草原的我,看什么都很新鲜。从河北到内蒙那段高速公路上,居然没什么车。成片成片的土地上,居然没什么树木,也没什么房屋,一路上全是草。草居然这么矮,跟我想象中一点都不一样。 火山附近,看到两个穿着太空服的游客,随手抓拍下来。草地还是偏绿的,这是调色后的效果。 可能是去过九寨沟的原因,这里的景色一点都看不上。不过,羊肉是真得好吃,烧麦也是真得好吃。 九月 草原天路 返程的路上,途径河北的张北县,特意绕道草原天路,看看这边的地理地貌。全程上百公里的草原,蜿蜒曲折的公路,这可给我这个平原长大的孩子开眼界了,一些都是新奇的。可还是去过九寨沟的原因,这种欣喜感来的快走的也快。还没开出河北,新鲜感就消失的无影无踪了,唯有途中餐厅的羊肉土豆,还能给我留点印象。 天路风车 沙棘草 天路上看到的植物,从来没见过,新鲜呐。有刺扎人,果实也不甜,酸酸的。不知道是不是有一些贱人朝着它头上施过肥。 十月 牡丹鹦鹉 中秋国庆假期,去金山区走亲访友。外甥家养鹦鹉这事我是知道的,也还是受我影响呢。只不过,我养的几只死的死,逃的逃,后来我把鹦鹉的大别墅送给了外甥。小外甥对鹦鹉特别贴心,特别宠爱,每天都跟它培养感情,这也是这只鹦鹉特别亲人的原因。 十月 机场的晚霞 还是出差,周五下午返程,在首都机场的座椅上打了个盹,醒来后就看到外面一片烧红了的天空。 繁忙的机场,和我一样繁忙。疲倦的太阳,和我一样疲倦。 十月 天凉好个秋 家附近的一个公园,总是受大家欢迎,每天都有很多人。尤其是周末,更是小学生的天下,划船项目最是热门。 十二月 技术峰会 因eBPF认识了何同学,常跟他交流eBPF在Linux安全上的应用,他也跟我反映过美团IOT设备的安全漏洞,一来二去也熟悉了。这次出差,正巧周末DeepFlow公司在他们学校有个eBPF技术峰会,就跟何同学来个线下网友见面,以及隔壁学下的王同学。寒冬腊月特别冷,路过此地,抓拍留念。 又一年 是的,这就是笔者2023年的经历,每一个昨天都是珍贵的经历,而每一个明天又是未知的旅程,你的经历是什么样的呢? 眼下又是元旦,下一个循环往复,一起来记录吧。C哥不光能教你写代码,还能教你拍照调色。 末 未觉池塘春草梦,阶前梧叶已秋声。 2023-12-30 0 0
击败 eBPF Uprobe 监控 这篇文章介绍了一种可以用于监控用户空间程序的 eBPF 程序。它首先向您介绍了 eBPF 和 uprobes,然后探讨了我们在 uprobes 中发现的缺陷,所有演示示例都适用于 Linux 和 x86_64 架构。原文地址:Defeating eBPF Uprobe Monitoring 简介 监控系统发生的事情非常重要。eBPF 可以通过将特定程序钩入各种系统范围的事件来帮助您在 Linux 服务器上执行此操作。您可以通过将内核或用户空间函数钩入来收集大量信息。例如,您可以读取两个进程之间加密通信的内容,或者查找使用特定库函数的进程。理解 eBPF 的一个好方法是记住这个图表: 要创建自己的 eBPF 程序,请选择一个 eBPF 库,它将生成 eBPF 字节码,然后调用 bpf 系统调用将其加载到内核中。在内核端,如果您的程序是安全的,它将经过验证并加载。您还必须记住,有不同类型的 eBPF 程序(适应触发事件),每种程序都可以访问不同的 eBPF 辅助程序和上下文。目前使用 eBPF 进行监控的工具通常涉及 kprobes(内核探针)。例如,这种类型的程序允许您记录每次进程使用系统调用的情况。然而,并非所有有趣的信息都可以通过这种方式捕获。这就是为什么正在对 uprobes(用户空间探针)进行新研究以进行用户空间监控的原因。 Uprobes:基础知识 定义 Uprobes 是允许钩入任何用户空间程序任意指令的内核功能。当触发这些钩子时,将创建一个事件,并向处理程序(例如,一个 eBPF 程序)提供被探测程序的上下文。然后,您可以记录 CPU 寄存器的值或执行一个 eBPF 程序。例如,由 Quarkslab 开发的 peetch 工具集使用 eBPF 和 uprobes 钩子在 OpenSSL 的 SSL_read() 和 SSL_write() 函数上,以记录系统范围的 TLS 消息并以纯文本形式访问数据。 如何创建 您可以通过向 /sys 伪文件系统添加一行到 /sys/kernel/debug/tracing/uprobe_events 文件来创建一个 uprobes。语法如下: p[:[GRP/]EVENT] PATH:OFFSET [FETCHARGS] : Set a uprobe r[:[GRP/]EVENT] PATH:OFFSET [FETCHARGS] : Set a return uprobe (uretprobe) -:[GRP/]EVENT : Clear uprobe or uretprobe event 更多细节,请参阅 内核文档。 示例 学习最好的方式是实践。让我们创建一个 uprobes,以打印系统中发出的每个命令。 首先,我们需要找一个地方来钩入。我们选择了 bash 二进制中的 readline()。这是一个不错的选择,因为我们的命令在函数结束时返回。现在,让我们找到 /bin/bash 中 readline 的偏移量。可以使用 gdb 快速实现: gdb /bin/bash (gdb) p readline $1 = {<text variable, no debug info>} 0xd5690 <readline> 如上 gdb 所示,我们的偏移量是 0xd5690。内核文档解释了我们可以在 uretprobe 中打印返回值。Uretprobes 实际上只是放置在函数末尾的 uprobes。我们的命令必须以 r: 开头,表示 "uretprobe",接着是我们的探针 bashReadline 的名称,二进制文件的路径 /bin/bash,偏移量 0xd5690,以及返回值打印为字符串的形式:cmd=+0($retval):string。 # First log-in as root. # This line creates a uretprobe named bashReadline at offset 0xd5690 of /bin/bash program that prints the return value as a string. echo 'r:bashReadline /bin/bash:0xd5690 cmd=+0($retval):string' >> /sys/kernel/tracing/uprobe_events # When the uprobe is added, activate it with this command: echo 1 > /sys/kernel/tracing/events/uprobes/bashReadline/enable cat /sys/kernel/tracing/trace_pipe bash-24834 [010] ..... 26372.295012: bashReadline: (0x5630d6af8015 <- 0x5630d6b98690) cmd="cat trace_pipe " <...>-14869 [014] ..... 26393.048772: bashReadline: (0x55f2c8640015 <- 0x55f2c86e0690) cmd="ls" bash-14869 [014] ..... 26399.267734: bashReadline: (0x55f2c8640015 <- 0x55f2c86e0690) cmd="whoami" <...>-24909 [010] ..... 26428.810573: bashReadline: (0x5638c7785015 <- 0x5638c7825690) cmd="cat /etc/passwd" 警告 如果在向 uprobe_events 文件写入时收到 设备或资源忙 的错误,请将 /sys/kernel/tracing/events/uprobes/enabled 设置为 0,然后重试。 如果收到 无效参数 错误,请阅读 /sys/kernel/tracing/error_log 文件以获取详细信息。 您的内核必须启用 CONFIG_UPROBES(如果您的 Linux 内核版本为 3.5 或更高版本,则默认启用)。 使用 eBPF 升级 如果您想要做的不仅仅是打印,并且要给您的 uprobes 添加一些逻辑,您可以使用 eBPF 程序。为简化起见,我们将使用做了繁重工作的 bcc Python 包。您只需使用构造函数创建一个 bpf 对象,并使用 attach_uretprobe() 方法将其挂接到 uretprobe 上。最后,我们编写一个简短的 eBPF 程序,读取命令和当前用户 ID,并在用户为 root 时打印它。 #!/usr/bin/python3 from bcc import BPF from time import sleep # load BPF program bpf_text=""" #include <linux/sched.h> int printForRoot(struct pt_regs *ctx){ char command[16] = {}; //use a bpf helper to get the user id. uid_t uid = bpf_get_current_uid_gid() & 0xffffffff; //another bpf helper to read a string in userland bpf_probe_read_user_str(&command, sizeof(command), (void *)PT_REGS_RC(ctx)); if(uid == 0){ bpf_trace_printk("Command from root: %s",command); } return 0; } """ b = BPF(text=bpf_text) b.attach_uretprobe(name="/bin/bash", sym="readline", fn_name="printForRoot") while(1): sleep(1) cat /sys/kernel/tracing/trace_pipe bash-9442 [000] d...1 2634.932058: bpf_trace_printk: Command from root: whoami bash-9442 [000] d...1 3575.645538: bpf_trace_printk: Command from root: cd /root/ bash-9442 [000] d...1 3584.413448: bpf_trace_printk: Command from root: sl 现在您已经了解了如何使用 uprobes,下一节将向您展示内核的工作原理。 uprobes 在幕后是如何工作的 Uprobe 创建 内核将 uprobes 实现为仅由内核使用的特殊断点。Uprobes 由程序文件 inode、指令偏移量、相关操作列表和替换指令代码组成。创建探测点时,它会被添加到特定的二叉树中。 在设置 uprobes 时,内核会调用 probes_write() 和 trace_uprobe_create(),它们又调用 __trace_uprobe_create()。最后一个函数以 uprobe_events 中的行作为参数,并调用 kern_path() 获取与我们路径相对应的文件的 inode。 随后,register_trace_uprobe()、_add_event_to_tracers() 和其他函数创建了伪目录 /sys/kernel/tracing/events/uprobes/<EVENT>/,以及一些文件(enable、id 等)。 probes_write(){ trace_uprobe_create(){ /* * Argument syntax: * - Add uprobe: p|r[:[GRP/]EVENT] PATH:OFFSET[%return][(REF)] [FETCHARGS] */ __trace_uprobe_create(int argc, const char **argv); } } Uprobe 激活 当我们启用 uprobes 时,会发生以下嵌套调用:trace_uprobe_register() => probe_event_enable() => trace_uprobe_enable() => uprobe_register()。 这最后一个函数调用了另外两个有趣的函数: alloc_uprobe(),它创建了一个带有 inode、偏移量和替换指令的 struct uprobe 并调用 insert_uprobe() 将这个 uprobe 添加到 uprobe rb_tree 中。 register_for_each_vma(),它循环遍历所有现有的虚拟内存区域,找到与某些 uprobe inode 相对应的内存区域(并验证 valid_vma())。对于这些 vma,它调用 install_breakpoint() 将完整的被探测指令复制到 arch.insn 中(一个取决于当前架构的结构),然后将其替换为断点。 trace_uprobe_register(){ probe_event_enable(){ trace_uprobe_enable(){ uprobe_register(){ alloc_uprobe(){ struct uprobe{ inode; offset; insn; } insert_uprobe(); } register_for_each_vma(){ if(valid_vma){ install_breakpoint(); } } } } } } 新程序实例的检测 当执行一个 ELF 程序时,它的内存使用 mmap 系统调用进行映射。在内核中,函数 mmap_region/vma_merge => __vma_adjust() 被调用以管理这种映射。__vma_adjust() 是一个在虚拟内存区域被添加/修改时使用的辅助函数。当文件支持的虚拟内存区域被修改时,它调用 uprobe_mmap()。我们程序的代码部分与其程序文件相连,所以 uprobe_mmap() 被用于包含我们 uprobe 的虚拟内存区域。 如果 valid_vma() 正常,它会使用 build_probe_list() 找到与 uprobe rb_tree 中相同 inode 的所有 uprobes,并为每个 uprobe 调用 install_breakpoint()。 SYS_mmap(){ mmap_region/vma_merge(){ __vma_adjust(){ uprobe_mmap(){ if(valid_vma){ build_probe_list(){ for each uprobe: install_breakpoint(); } } } } } } 记住,在 mmap 调用期间会将 uprobes 添加到新的程序实例中! Uprobe 事件 当达到断点时,会触发 int3 异常。do_int3() 调用 notify_die(DIE_INT3, …),然后调用 atomic_notifier_call_chain(&die_chain, …)。链 die_chain 包含了之前通过 register_die_notifier() 注册的所有通知者。atomic_notifier_call_chain 调用 notifier_call_chain(),通过其 notifier_call 属性通知链中注册的通知者有关事件的信息。对于我们的 uprobes,它是在 uprobe_init() 中设置的 arch_uprobe_exception_notify()。它调用 uprobe_pre_sstep_notifier(),该函数设置了 TIF_UPROBE 标志。在返回到用户空间时,线程注意到了 TIF_UPROBE 标志,并调用 uprobe_notify_resume(struct pt_regs * regs),该函数调用 handle_swbp(regs)。 此函数执行两个主要操作: handler_chain(find_active_uprobe()),执行此 uprobes 的处理程序。例如,由 eBPF 程序使用的 perf_event。 pre_ssout(),准备对被探测指令进行单步执行。这个指令不能在程序内存中执行,因为原始指令已被 uprobes 断点指令替换。内核开发人员首先尝试暂时删除断点,但存在一些问题,因此选择在一个新的内存区域中执行这个指令(也称为 xol)。因此,它首先调用 xol_get_insn_slot 获取 xol 虚拟地址,此函数使用 get_xol_area(),如果尚未创建 uprobes 特殊虚拟内存区域,则会创建该区域,并使用 xol_add_vma() => install_special_mapping()。这个 vma 是原始指令将要在 xol 中执行的地方。继续执行 pre_ssout(),它使用 arch_uprobe_pre_xol() 调用 regs_set_return_ip(regs, current->utask->xol_vaddr) 和 user_enable_single_step()。此时 current->utask->xol_vaddr 指向之前创建的分配的 XOL slot。因此,此函数将程序计数器设置为原始指令的副本所在的位置,并激活单步模式。然后,执行这个指令,并再次停止程序。 当单步执行结束时,arch_uprobe_post_xol 从 uprobe_notify_resume 中调用。此函数准备在单步执行后恢复执行,并调用 post_xol 处理程序。默认情况下,它是 default_post_xol_op(也可以看看 branch_post_xol_op)。新的 RIP 寄存器是相对于复制的指令的,因此它使其相对于原始指令(有一些例外,比如返回、调用、绝对或间接跳转等)。如果指令使用了 RIP,则将其替换为另一个寄存器。恢复这个寄存器的值,最后恢复程序的执行。 [...] uprobe_init(){ register_die_notifier(arch_uprobe_exception_notify); } [...]//breakpoint is reached do_int3(){ notify_die(DIE_INT3, ...){ atomic_notifier_call_chain(&die_chain, ...){ notifier_call_chain(){ for each: notifier_call = arch_uprobe_exception_notify(){ uprobe_pre_sstep_notifier(){ //set TIF_UPROBE flag } } } } } } [...] exit_to_user_mode_prepare() { exit_to_user_mode_loop() { uprobe_notify_resume(struct pt_regs * regs){ handle_swbp(regs){ handler_chain(find_active_uprobe()); pre_ssout(){ xol_get_insn_slot(){ get_xol_area(){ __create_xol_area(){ xol_add_vma(){ install_special_mapping(); } } } } arch_uprobe_pre_xol(){ regs_set_return_ip(regs, current->utask->xol_vaddr); } user_enable_single_step(); } } } } } [...]//single_step uprobe_notify_resume(struct pt_regs * regs){ arch_uprobe_post_xol(){ post_xol = default_post_xol_op(); } } 总结一下,当触发断点时,会执行处理程序,然后执行替换为断点的原始指令,它在一个特殊的虚拟内存区域中执行 与 uprobes 一起玩耍 我们已经知道 uprobes/eBPF 组合是一种获取系统所有进程数据的非常高效的方式。例如,在 Quarkslab,我们创建了 peetch,它记录了所有明文的 TLS 连接(在加密过程之前)。但是,从安全的角度来看,这些数据能够被信任吗?还是只是提供了信息而已? 在这一节中,我们假设编写了一个将被 uprobes 监控/检测的程序。让我们看看我们可以用这些 uprobes 做些什么。 检测 uprobes Uprobes 基于断点,因此我们可以使用常见的反调试技巧来检测它们。受监视程序快速且不太正规的方法是读取其 .text 内存,然后搜索断点操作码。 下面的 C 代码片段通过读取 tracedFunction 的第一个字节,并检查是否对应于断点操作码(0xcc)来实现此功能。 unsigned char * functionBytes = (unsigned char *) &tracedFunction; if (functionBytes[0] == 0xcc){ printf("Detected uprobe breakpoint in beginning of tracedFunction.\n"); } 问题在于,你可能必须检查每条指令,并将其与二进制文件中的实际指令进行比较,以避免误报。 另一种方法是在触发 uprobe 后检测它。利用我们对内核内部工作原理的了解,我们知道创建了一个特殊的内存映射,称为 [uprobes],用于执行原始指令。因此,我们的被监视程序可以读取 /proc/self/maps,并搜索此类映射。 bool detect_uprobes(){ FILE * memfile = fopen("/proc/self/maps", "r"); char line[200]; while(fgets(line, 200, memfile) != NULL){ char * uprobes_str = strstr(line,"[uprobes]");//search for "[uprobes]" in line if(uprobes_str != NULL){ return true; } } return false; } uprobes 监控逃逸 根据 Uprobe 激活 和 检测新程序实例 段落的内容,我们知道在添加断点之前始终会调用 valid_vma() 函数。让我们来看看这个函数的代码: static bool valid_vma(struct vm_area_struct *vma, bool is_register){ vm_flags_t flags = VM_HUGETLB | VM_MAYEXEC | VM_MAYSHARE; if (is_register) flags |= VM_WRITE; return vma->vm_file && (vma->vm_flags & flags) == VM_MAYEXEC; } 在 uprobe 注册期间,is_register 被启用。我们的代码是由程序文件支持的,所以 vma->vm_file 为 true,而且我们的代码具有执行标志,因此 VM_MAY_EXEC 也为 true。这个函数的有趣之处在于,如果我们的代码具有 VM_WRITE 标志,虚拟内存区域就不被视为有效的 vma,因此断点永远不会添加到我们的代码部分(.text)。 一个简单的方法是编辑包含 .text 部分的 ELF 段的权限,而 Quarkslab 提供了一个很好用的工具:lief。 import lief prog = "./bin/prog" binary = lief.parse(prog) binary.segment_from_offset(binary.get_section(".text").offset).flags = lief.ELF.SEGMENT_FLAGS(7) binary.write(prog) 这些技术结合一下: char isRoot(int uid){ if(detect_uprobes()){ printf("Previous uprobe usage detected.\n"); }else{ printf("No uprobe has been activated.\n"); } return uid == 0; } int main(int argc, char * argv[]){ if(argc == 2 && argv[1][0] == '1'){ unsigned char * funcBytes = (unsigned char *) &isRoot; if (funcBytes[0] == 0xcc) { int pagesize = sysconf(_SC_PAGE_SIZE); char * debut_page = ((char *) &isRoot) - ((long)&isRoot % pagesize);//find page aligned address mprotect(debut_page, pagesize, PROT_WRITE | PROT_READ | PROT_EXEC); printf("Detected uprobe breakpoint at the beginning of tracedFunction.\n"); funcBytes[0] = 0xf3; } }else if(argc != 2 || argv[1][0] != '0'){ printf("Usage:\n\t%s 0 : to disable anti-uprobe\n\t%s 1 : to enable anti-uprobe\n", argv[0], argv[0]); exit(1); } //PoC function isRoot(getuid()); return 0; } 这个程序有两种模式: 没有任何检测(即常规执行) 在 isRoot 上检测断点(以及修补)。 无论哪种情况,它都使用第二种检测技术来查找是否有任何 uprobes 被激活。 让我们试一试: # We begin without uprobe user@pc:~/ebpf-for-security/uprobe$ ./bin/prog Usage: ./bin/prog 0 : to disable anti-uprobe ./bin/prog 1 : to enable anti-uprobe user@pc:~/ebpf-for-security/uprobe$ ./bin/prog 0 No uprobe has been activated. Print from testFunction user@pc:~/ebpf-for-security/uprobe$ gdb ./bin/prog -q # We find isRoot function offset Reading symbols from ./bin/prog... (gdb) p isRoot $1 = {void ()} 0x1320 <isRoot> ----------------- # Now we activate the uprobe root@pc:~# echo 'p:isRootFunction /home/cglenaz/Documents/eBPF/gitlab/ebpf-for-security/uprobe/bin/prog:0x1320 uid=%di:u32' > /sys/kernel/tracing/uprobe_events ------------------------------------------------------- user@pc:~/ebpf-for-security/uprobe$ ./bin/prog 0 Previous uprobe usage detected. # our uprobe is detected! ------------------------------------------------------- # Let's read the uprobe output: cat /sys/kernel/tracing/trace_pipe prog-19936 [013] ..... 19399.726502: isRootFunction: (0x55ff8a5b8320) uid=1000 # The uprobe has intercepted the uid ------------------------------------------------------- user@pc:~/ebpf-for-security/uprobe$ ./bin/prog 1 # we test the first detection and mitigation strategy Detected uprobe breakpoint in beginning of testFunction. No uprobe has been activated. # it works ------------------------------------------------------- # Let's see if something is printed: cat /sys/kernel/tracing/trace_pipe # nothing is printed in trace_pipe because the uprobe is not activated ------------------------------------------------------- user@pc:~/ebpf-for-security/uprobe$ python3 permission.py # now we patch the binary with lief user@pc:~/ebpf-for-security/uprobe$ ./bin/prog 0 No uprobe has been activated. # no more uprobe on this program ------------------------------------------------------- cat /sys/kernel/tracing/trace_pipe # nothing again in trace_pipe ------------------------------------------------------- 这个技巧在我们程序的 isRoot 函数上效果很好,但对于共享库不起作用。而且,你必须是 root 用户才能编辑特权 ELF 库,比如 libc,所以你必须在它们加载到程序内存之前修改权限(或者你也可以编写一个自定义的 ELF 加载器,为每个库添加写权限)。你的程序可以再次读取 /proc/self/maps 来找到所有来自库的可执行 vma。 示例: 55cc466af000-55cc466b1000 r--p 00000000 fd:01 22282389 /usr/bin/cat 55cc466b1000-55cc466b5000 r-xp 00002000 fd:01 22282389 /usr/bin/cat 55cc466b5000-55cc466b7000 r--p 00006000 fd:01 22282389 /usr/bin/cat 55cc466b7000-55cc466b8000 r--p 00007000 fd:01 22282389 /usr/bin/cat 55cc466b8000-55cc466b9000 rw-p 00008000 fd:01 22282389 /usr/bin/cat 55cc4807f000-55cc480a0000 rw-p 00000000 00:00 0 [heap] 7f32c7ce9000-7f32c7d0b000 rw-p 00000000 00:00 0 7f32c7d0b000-7f32c8af2000 r--p 00000000 fd:01 22287657 /usr/lib/locale/locale-archive 7f32c8af2000-7f32c8af5000 rw-p 00000000 00:00 0 7f32c8af5000-7f32c8b1d000 r--p 00000000 fd:01 22288450 /usr/lib/x86_64-linux-gnu/libc.so.6 7f32c8b1d000-7f32c8cb2000 r-xp 00028000 fd:01 22288450 /usr/lib/x86_64-linux-gnu/libc.so.6 7f32c8cb2000-7f32c8d0a000 r--p 001bd000 fd:01 22288450 /usr/lib/x86_64-linux-gnu/libc.so.6 7f32c8d0a000-7f32c8d0e000 r--p 00214000 fd:01 22288450 /usr/lib/x86_64-linux-gnu/libc.so.6 7f32c8d0e000-7f32c8d10000 rw-p 00218000 fd:01 22288450 /usr/lib/x86_64-linux-gnu/libc.so.6 7f32c8d10000-7f32c8d1d000 rw-p 00000000 00:00 0 7f32c8d30000-7f32c8d32000 rw-p 00000000 00:00 0 7f32c8d32000-7f32c8d34000 r--p 00000000 fd:01 22288113 /usr/lib/x86_64-linux-gnu/ld-linux-x86-64.so.2 7f32c8d34000-7f32c8d5e000 r-xp 00002000 fd:01 22288113 /usr/lib/x86_64-linux-gnu/ld-linux-x86-64.so.2 7f32c8d5e000-7f32c8d69000 r--p 0002c000 fd:01 22288113 /usr/lib/x86_64-linux-gnu/ld-linux-x86-64.so.2 7f32c8d6a000-7f32c8d6c000 r--p 00037000 fd:01 22288113 /usr/lib/x86_64-linux-gnu/ld-linux-x86-64.so.2 7f32c8d6c000-7f32c8d6e000 rw-p 00039000 fd:01 22288113 /usr/lib/x86_64-linux-gnu/ld-linux-x86-64.so.2 7ffd18ebb000-7ffd18edc000 rw-p 00000000 00:00 0 [stack] 7ffd18ee6000-7ffd18eea000 r--p 00000000 00:00 0 [vvar] 7ffd18eea000-7ffd18eec000 r-xp 00000000 00:00 0 [vdso] ffffffffff600000-ffffffffff601000 --xp 00000000 00:00 0 [vsyscall] 感兴趣的虚拟内存区域: 7f32c8b1d000-7f32c8cb2000 r-xp 00028000 fd:01 22288450 /usr/lib/x86_64-linux-gnu/libc.so.6 7f32c8d34000-7f32c8d5e000 r-xp 00002000 fd:01 22288113 /usr/lib/x86_64-linux-gnu/ld-linux-x86-64.so.2 每个 vma,你必须使用 munmap 系统调用取消映射该 vma 以删除 uprobes,并使用 mmap 系统调用重新映射具有写权限的完全相同的 vma。只有一个注意事项:当 libc 被取消映射时,你无法使用 libc 中的 mmap 函数。这就是为什么你必须直接在你的程序中硬编码系统调用的汇编指令。 extern long int syscall (long int __sysno, ...){ asm("mov %rdi,%rax"); asm("mov %rsi,%rdi"); asm("mov %rdx,%rsi"); asm("mov %rcx,%rdx"); asm("mov %r8,%r10"); asm("mov %r9,%r8"); asm("mov 0x10(%rbp),%r9"); asm("syscall"); } void remove_lib_uprobes(){ FILE * memfile = fopen("/proc/self/maps", "r"); char line[200]; while(fgets(line, 200, memfile) != NULL){ char * lib_str = strstr(line,".so");//find all libraries char * r_xp = strstr(line,"r-xp");// only their code sections if(lib_str != NULL && r_xp != NULL){ //read the start and end address. And the file offset. char * dash = strchr(line, '-'); dash[0] = '\0'; char * space = strchr(dash + 1, ' '); space[0] = '\0'; char * space2 = strchr(space + 1, ' '); space2[0] = '\0'; char * space3 = strchr(space2 + 1, ' '); space3[0] = '\0'; unsigned long addr1 = strtol(line, NULL, 16); unsigned long addr2 = strtol(dash + 1, NULL, 16); unsigned long offset = strtol(space2 + 1, NULL, 16); unsigned long delta = addr2-addr1; //now read the library file name // Locate the last occurrence of space in line (the one before the lib name) char * name_lib = strrchr(space3 + 1, ' ') + 1; name_lib[strlen(name_lib)-1] = 0; //replace the \n by '\0' long int fd = open(name_lib, O_RDONLY); syscall(SYS_munmap,(void *) addr1, delta); syscall(SYS_mmap,(void *) addr1, delta, (unsigned long) PROT_EXEC | PROT_READ | PROT_WRITE, (unsigned long) MAP_PRIVATE, (unsigned long) fd, (void *) offset); } } } 提供虚假信息 现在我们能够检测和禁用 uprobes,我们可以尝试向一个挂接在 uprobes 上的 eBPF 程序发送虚假的上下文信息。让我们试图伪造 sudo peetch tls --content 命令的输出。我们的程序将发送一个 GET 请求到 “evil” 文件,但 peetch 将监视对 “test” 文件的请求。这怎么可能?我们将利用在 uprobes 断点触发和消息实际加密之间的竞争条件。第一种策略是创建另一个线程,希望它在正确的时刻更改文件名;但这种方法只有 50% 的成功率,我们可以做得更好。事实上,我们可以控制我们程序的执行,所以我们可以将我们的程序分叉为两个进程: 一个子进程,在此调用 SSL_write 时使用假文件名并在此调用之前放置一个断点。 一个父进程,使用 PTRACE_SEIZE 附加到子进程,并使用 PTRACE_SINGLESTEP 逐条执行 CHILD 的指令。从断点开始,我们必须逐步执行设置寄存器中的 ptrace 参数和准备跳转到库的指令。在我们的情况下,在断点和 ptrace 的第二条指令之间恰好有 9 条指令。当子进程到达 SSL_write 的第二条指令时,uprobes 已经执行,所以我们现在可以将 SSL_write 的消息缓冲区更改为真实的文件名。我们使用 PTRACE_GETREGS 复制寄存器,修改 rsi 值(rsi 用于第二个参数),然后调用 PTRACE_SETREGS。最后,我们可以使用 PTRACE_CONT 恢复子进程的执行。 请注意,这第二种方法比第一种方法需要更高的特权级别,因为它使用了 ptrace 系统调用。 void SSL_write_race_condition(SSL* ssl, char * realName, char * fakeName){ char format[] = "GET /%s HTTP/1.0\r\n\r\n"; int fakeMsgLen = strlen(format) + strlen(fakeName); char realMsg[fakeMsgLen]; char fakeMsg[fakeMsgLen]; sprintf(fakeMsg, format, fakeName); sprintf(realMsg, format, realName); printf("\nMessage before the uprobe: %s\n", fakeMsg); pid_t pid_fils = fork(); if(pid_fils != 0){ ptrace(PTRACE_SEIZE, pid_fils, NULL, NULL); printf("Attached\n"); wait(NULL); struct user_regs_struct luser; for(int i=0; i<9; i++){//9 instructions between int3 and the first instruction of SSL_write ptrace(PTRACE_SINGLESTEP, pid_fils, NULL, NULL);//step one instruction wait(NULL);//wait for the step to be done } ptrace(PTRACE_GETREGS, pid_fils, NULL, &luser); luser.rsi = (long long unsigned int) realMsg;//change the SSL_write second argument to our real message printf("Set rsi to realMsg...\n"); ptrace(PTRACE_SETREGS, pid_fils, NULL, &luser) == -1); ptrace(PTRACE_CONT, pid_fils, NULL, NULL);//continue the SSL_write printf("Continue execution of SSL_write\n"); exit(1); }else{ ptrace(PTRACE_TRACEME, 0, 0, 0);//wait for the parent to trace this child __asm__("int3");//the breakpoint to stop the child just before SSL_write SSL_write(ssl, fakeMsg, fakeMsgLen); // encrypt and send message } } 我们需要创建一个测试的HTTPS server: from http.server import HTTPServer, BaseHTTPRequestHandler import ssl from io import BytesIO class SimpleHTTPRequestHandler(BaseHTTPRequestHandler): def do_GET(self): if self.path == "/test": self.send_response(200) self.send_header('Content-Type', 'text/html') self.send_header('Content-Length', str(len(b'<html>Hello, world!</html>\r\n\r\n'))) self.end_headers() self.wfile.write(b"<html>Hello, world!</html>\r\n\r\n") elif self.path == "/evil": self.send_response(200) self.send_header('Content-Type', 'text/html') self.send_header('Content-Length', str(len(b'<html>Hello, evil man!</html>\r\n\r\n'))) self.end_headers() self.wfile.write(b'<html>Hello, evil man!</html>\r\n\r\n') return True httpd = HTTPServer(('localhost', 4443), SimpleHTTPRequestHandler) #first create key : openssl req -x509 -newkey rsa:2048 -keyout key.pem -out cert.pem -days 365 #(example key pass = pass) httpd.socket = ssl.wrap_socket (httpd.socket, keyfile="./key.pem", certfile='./cert.pem', server_side=True) httpd.serve_forever() 这个 Python 服务器在我们请求 /evil 端点时返回 “Hello, evil man!”,而在 /test 端点返回 “Hello, world!”。 然后我们启动 peetch 并发起我们的攻击。 让我们看看结果: Message before the uprobe: GET /test HTTP/1.0 Attached rip=0x5613718b8deb Single-step rip=0x5613718b8df1 Single-step rip=0x5613718b8df8 Single-step rip=0x5613718b8dff Single-step rip=0x5613718b8e02 Single-step rip=0x5613718b8e05 Single-step rip=0x5613718b8510 Single-step rip=0x5613718b8514 Single-step rip=0x7f3fe29ba240 Single-step Set rsi to realMsg... Continue execution of SSL_write [+] Server data received : HTTP/1.0 200 OK Server: BaseHTTP/0.6 Python/3.10.4 Date: Wed, 06 Jul 2022 09:25:21 GMT Content-Type: text/html Content-Length: 29 <html>Hello, evil man!</html> 这很有效,文件名在消息发送之前被替换,所以我们收到了“Hello, evil man!”的消息。让我们检查一下 peetch 是否意识到我们的恶意行为: <- client (12918) 127.0.0.1/4443 TLS1.3 None 0000 47 45 54 20 2F 74 65 73 74 20 48 54 54 50 2F 31 GET /test HTTP/1 0010 2E 30 0D 0A 0D 0A 00 00 .0...... -> client (12918) 127.0.0.1/4443 TLS1.3 None 0000 48 54 54 50 2F 31 2E 30 20 32 30 30 20 4F 4B 0D HTTP/1.0 200 OK. 0010 0A 53 65 72 76 65 72 3A 20 42 61 73 65 48 54 54 .Server: BaseHTT 0020 50 2F 30 2E 36 20 50 79 74 68 6F 6E 2F 33 2E 31 P/0.6 Python/3.1 0030 30 2E 34 0D 0A 44 61 74 65 3A 20 57 65 64 2C 20 0.4..Date: Wed, 攻击成功,peetch已经监视了伪造的消息! 我们的攻击现在每次发送消息都会生效,而且可以轻松地适应不同的情况。因此,我们可以使用这种攻击方法来向使用先前方法检测到的任何 uprobes 提供虚假信息。 从另一个角度来看,这种攻击很容易被检测出来。您可以使用 kprobes 跟踪任何 PTRACE_SETREGS 并观察 rip 寄存器是否在包含您的 uprobes 的函数中。然而,攻击也可以使用线程(精度较低)进行,并且更难以检测。但是,如果攻击者可以使用我们先前的技巧轻松禁用任何 uprobes,那么研究此类攻击的意义又在哪里呢? 结论 我们发现一个程序可以通过自身代码和库执行任何操作,以欺骗 uprobes,因此基于 uprobes 的 eBPF 程序不是一种可靠的监视_不受信任_程序的方法,但它们是收集信息的强大工具。如果您想要监视程序以检测恶意行为,那么 kprobes 更适合此目的。它们基本上具有 uprobes 的相同功能,但在内核方面实现。竞争条件仍然可能存在问题,因此最好在 LSM(Linux 安全模块)中定义的安全点上挂接 kprobes。 2023-11-27 0 0
GitHub 7K星:eCapture新版支持Android 13、14 eCapture是一个无需CA证书,即可捕获HTTPS/TLS明文的抓包工具,常用语网络分析、故障定位等。最初定位是Linux上的抓包工具,在2022年9月支持了Android系统,在Android 12起,只要是Linux内核是5.5以上的ARM架构,都可以正常运行。支持TLS 1.2、TLS1.3版本的协议,只需要root,无需应用重启、更改等,很受大家欢迎。 今天,eCapture v0.6.5 版本发布,支持了两个功能:支持所有端口的网络包、支持Android 13和Android 14。 新版本 近两年,Android也陆续发布了13、14版本,eCapture做了一些 兼容更新,支持了Android 13、Android 14版本的BoringSSL类库的明文捕获。 除此之外,去掉了捕获端口的限制,如果--port参数为0时,可以捕获所有端口的网络数据,并保存到pcapng中。否则则只捕获--port对应的端口数据,默认是443 端口。 下载使用 eCapture v0.6.5 下载地址见GitHub仓库:https://github.com/gojue/ecapture/releases/tag/v0.6.5 使用方法,可参见以往教程eCapture旁观者:Android HTTPS明文抓包 功能回顾 BoringSSL介绍 自支持Android至今,已经有一年多,其程序使用的默认SSL动态链接库是BoringSSL,fork自OpenSSL。这个类库广泛使用在Google的的各种产品里,包括Chrome、Android等。但他们不是同一个版本,完全是独立维护的两个Git仓库。情况如下: Android上的BoringSSL: BoringSSL Android仓库 非Android的BoringSSL:BoringSSL Github仓库 更让人无法理解的是,即使在Android不同发行版里,不管BoringSSL代码如何更新,都不更类库的新版本信息,都是OpenSSL 1.1.1 (compatible; BoringSSL), OPENSSL_VERSION_NUMBER是269488255。对使用者来说没影响,可对 eCapture来说就很头疼。SSL结构体的元素offset发生变化,很难根据版本号选择不同的offset值了。相对来说,OpenSSL就做得很好,只需要从动态链接库的ELF文件中读取openssl的版本号,再选择对应offset配置即可。 在Android 14里,BoringSSL的很多结构体改动较大,必需要用单独的eBPF 字节码文件,笔者花了整个周六的时间,想出一个机智地、取巧地思路,给兼容了。 捕获端口限制 早期,eCapture的pcapng模式是限制了网络捕获包的端口,--port参数只能是80 、443 。技术上都已经实现,没有难点。默认没有捕获所有网络包,是因为有很多场景,主机的网络流量很大,eBPF的map写入太快,用户空间消费过慢,导致丢包的问题。 虽然用户空间在创建eBPF map时,已经申请了BufferSizeOfEbpfMap大的内存,但仍然还存在网络包过多导致数据丢失的可能。 而且,在Android上有内存大小限制,BufferSizeOfEbpfMap的值仅为1024,即PageSize*1024,一般情况下是4M。 rd, err := perf.NewReader(em, os.Getpagesize()*BufferSizeOfEbpfMap) 也就是说,如果你启用所有端口的网络捕获,则可能会发生网络包未成功捕获的情况。 除此之外,你可以用eCapture来替换tcpdump使用,而且还多了HTTPS的明文捕获呢。 相关文章 如果你刚刚知道eCapture,对他的功能还不了解,你可以阅读本公众号的更多文章来了解。 eCapture旁观者支持Golang tls/https加密明文捕获 eCapture支持borgingssl TLS 1.3明文捕获 eCapture:无需CA证书抓https网络明文通讯 招聘信息 美团信息安全部长期招人,网络安全领域的研发方向,研发产品包括不限于HIDS/HIPS、RASP、EDR、WAF、零信任产品、NIDS等等,方向包括客户端软件、服务端后台,技术语言包括不限于C/C++、Golang、Java、Object-C、Swift等。 欢迎公众包内发私信联系,其他方向的岗位笔者也可协助内推到对应岗位部门。 2023-11-14 1 0
eBPF应用程序开发:快人一步 这篇文章提供了关于eBPF应用程序开发的指南。正如标题所示,文章主要关注eBPF 201的概念,而不是提供另一篇关于eBPF技术是什么的入门级文章。我们提供了简短的介绍,但主要关注需要部署生产eBPF应用程序的开发团队的下一组概念和最佳实践。我们将探讨使BPF应用程序可以在多个内核版本和环境中部署和维护的编程语言和工具链。 eBPF 101: 简短回顾 BPF/eBPF是由轻量级的隔离虚拟机和一组辅助函数组成的操作系统内核技术。在本文中,我们关注Linux内核中的eBPF,尽管它也适用于其他操作系统平台,如Windows和FreeBSD。 这项技术使用户能够在内核中运行提供的程序,以扩展内核的功能。验证程序在加载到内核之前会检查BPF程序,以确保它们不会危及内核的可靠性。这些程序会被JIT(Just-In-Time)编译成本机指令,因此它们足够高效,可以在性能要求最高的情况下执行,例如网络数据包处理。 总体的好处是以一种安全、更灵活且开发速度更快的方式为操作系统内核提供可编程性和可扩展性,而不是开发内核模块或直接增强主要内核功能本身。 下图中的图表显示了Linux内核中的BPF虚拟机、BPF程序可以附加的挂钩点以及BPF程序可用的各种映射和辅助函数。 如果你对eBPF还不熟悉,eBPF详尽介绍将为你提供一个很好的基础,然后再阅读本文的其余部分。 技术成熟度 BPF已经从早期作为Linux内核的数据包过滤引擎(图2)的时代走来了很长的路。在过去的十年中,eBPF VM已经成为一种通用执行引擎,由Clang工具链支持,具有许多不同用途的程序类型和辅助函数。最近,重点放在了开发者和操作用户体验上,由BTF、CO-RE和libbpf支持。 BPF功能已经在从3.15到最新的6.x版本的许多内核中引入。在任何给定的内核版本中找出可用的功能集可能是困难的。BCC项目维护了一个有用的BPF功能按Linux内核版本排序的列表,它可以帮助你确定在给定的Linux内核中的功能可用性。 eBPF应用程序开发常见问题解答 以下是开发人员在学习eBPF应用程序开发时常遇到的一些常见问题。在本文中,我们试图提供这些问题的一些答案,同时注意到这个领域仍在不断发展,一些内容将在未来发生变化。 Q:用于eBPF应用程序的编程语言和开发工具有哪些选择,以及每种选择的利弊是什么? A:这将在本文的选择您的eBPF应用程序栈部分中进行讨论。 Q:我们了解eBPF的概念,但迄今为止还没有进行任何内核开发。为了有效地开发eBPF应用程序,我们需要了解内核源代码的相关部分和开发环境吗? A:开发内核经验不是开发基于eBPF的应用程序所必需的。然而,强烈建议对内核中相关的功能领域有很好的了解。例如,当开发网络应用程序时,您应该了解与网络套接字、内核数据包路径、netfilter功能等相关的一些内核内部内容。 Q:在跨目标方式开发eBPF应用程序时,其中开发涉及多个开发系统和内核版本,同时存在多个目标系统和平台,旨在实现跨所有这些平台的可移植性和可维护性,我们需要了解哪些内容? A:这将在本文的eBPF应用程序跨开发、可移植性、CO-RE和内核API稳定性部分中进行讨论。 Q:有哪些实际的分发eBPF程序和在单个系统中并发安装来自多个供应商的程序的操作模型? A:在撰写本文时,这是一个新兴的开发领域。目前,eBPF程序通常被打包为较大项目中的不可分割的子组件,例如Cilium或Pixie。结合和安装多个独立的基于eBPF的应用程序可能会导致不一致或错误的行为,特别是如果在使用的eBPF附加点中存在重叠(如在最近的案例中所示)。 新项目,如libxdp和bpfd,正在添加功能以解决此类操作问题。我们期望在未来的文章中更详细地介绍这些项目。 Q:上游核心eBPF开发模型是什么,我们如何跟踪仍在开发中的eBPF功能? A:新的eBPF内核基础设施和功能是在Linux内核的“bpf-next” git存储库中开发的,最终合并到主要的Linux存储库中,作为正式的Linux内核发布的一部分。该过程在BPF开发FAQ中有更详细的描述。 此外,内核BPF函数越来越多地作为kfuncs(内核函数)添加。它们提供了eBPF应用程序可以调用的API,但相对于内核BPF辅助函数的稳定性较低,后者被认为是内核ABI的一部分。正在使用的kfunc API将得到支持和维护,但不属于内核ABI。 Q:在编写eBPF应用程序时,需要注意哪些软件许可要求? A:Linux内核eBPF运行时的组件使用GPLv2许可证。这包括参考解释器、验证器、JIT编译器和BPF助手等组件。所有kfuncs和许多(但不是全部)BPF助手都是GPL许可的,这意味着BPF应用程序通常(尽管不总是)需要以GPL-v2兼容许可证发布。请注意,没有兼容许可归属的BPF验证器将不允许加载BPF应用程序。为了启用一些宽松的下游代码重用,应用程序可以考虑使用双重许可,此外将其BPF应用程序许可为诸如MIT、BSD-2-Clause等宽松许可证。有关更多详细信息,请参阅Linux内核文档的BPF许可指南。 Q:eBPF技术是否促进或与内核数据平面卸载技术交汇? A:对于Linux内核功能,特别是网络功能的硬件卸载到智能网卡是一个广泛的话题,涵盖了许多超出本博客范围的技术。暂时简要说明一下,您确实可以利用eBPF技术来进行硬件卸载。例如,像ConnectX-6这样的某些智能网卡支持将基于XDP的eBPF程序从主机CPU卸载到网卡上的CPU。 选择您的eBPF应用程序栈 在启动新的eBPF项目时,开发团队需要决定使用哪种软件栈来开发计划中的应用程序。有多种编程语言和可用的库,具有不同的成熟度和与最新内核BPF功能的特性相匹配。 以下是eBPF应用程序的常见选择,也是新项目的不错选择: 用户空间程序使用 C,内核空间BPF程序使用C 用户空间程序使用 Golang,内核空间BPF程序使用C 用户空间程序使用 Rust,内核空间BPF程序使用Rust 这些应用程序开发栈如图3所示。 还有一种低代码选项,团队可以利用可用工具,如iproute2的tc、bpftool和bpftrace来处理计划中应用程序的用户空间和/或内核BPF程序。 需要注意的一个关键点是,以这种方式列出这些选项并不排除在这些选项以及其他选项之间混合和匹配的可能性。例如,您可以使用C编写内核空间eBPF程序,然后在用户空间使用Golang或Rust编写相应的程序,通常有很多理由这样做。还有更多的选项,包括通过直接调用内核ebpf系统调用或使用像BCC这样的框架编写自己的自定义eBPF加载程序。但通常情况下,本文列出的选项将更适合新项目,我们将讨论这些选项以阐明一些核心概念。 使用C和带libbpf(可选的libbpf-bootstrap)的C 这种软件栈选择通常是最全面的,支持最新的eBPF功能和工具。 关于libbpf libbpf是一个C库,提供eBPF实用函数和定义,用户空间程序可以使用它来管理内核空间的eBPF程序。这个应用程序栈选项是最新的,是上游Linux源代码仓库的一部分,与最新的eBPF功能保持一致,并用于测试新的内核eBPF功能。这个库和内核BPF代码由内核开发人员共同编写、审查和测试,作为引入新的eBPF功能的一部分。libbpf还是CO-RE(Compile Once Run Everywhere)功能的官方实现,该功能在提供eBPF程序可移植性方面显著改进了开发人员的体验,后文将详细讨论。 在Linux源代码仓库中,libbpf位于tools/lib/bpf。API文档可在https://libbpf.readthedocs.io/en/latest/api.html 到。 与内核源代码分开维护的libbpf的镜像应该用于包含在应用程序中。该API包括一些关键的定义,如eBPF帮助函数的原型定义,用户空间类型定义以匹配相应的内核类型,并用于加载和附加程序以设置eBPF映射的函数。libbpf库于2022年中发布了1.0版本,并且正在积极开发,最近发布了1.2版本。 关于libbpf-bootstrap libbpf-bootstrap是libbpf的伴随仓库之一,提供了使用libbpf功能的一组有用的模板和示例程序。这是一个快速编写用户空间程序的良好起点,该程序将与最新的eBPF功能一起使用。libbpf-bootstrap仓库还说明了使用bpftool实用程序准备eBPF骨架程序的方法。骨架是一组由用户空间程序使用的类型和函数的定义,以便轻松打开、加载、附加和销毁eBPF程序对象。 建议和要点 1. 这经常是编写eBPF应用程序时的一个不错的栈选择。 在我们看来,这种应用程序栈是开发团队采用的一个可靠选择,特别是如果需要使用C语言用户空间程序或者需要最新的eBPF功能,这些功能可能并不总是通过其他用户空间加载器和其他编程语言和工具的实用程序获得。 举例来说,在撰写本文时,这是作者用来管理、加载和附加使用新eBPF kfuncs(内核函数)的eBPF应用程序的几个可行选项之一。 2. 在应用程序仓库中将libbpf和bpftool作为git子模块包含。 我们还注意到,开发人员通常应通过将libbpf包含为其应用程序程序仓库中的Git子模块来使用libbpf。这可以确保他们始终使用libbpf的最新发布版本,而不是他们可能在开发系统上拥有的内核源代码版本,或者由Linux发行版捆绑的版本。 3. 考虑使用libbpf-bootstrap作为应用程序程序的参考仓库。 在作者看来,libbpf-bootstrap是用于新的eBPF项目或基于libbpf的应用程序的参考仓库。它作为使用libbpf的最佳实践示例进行维护(例如,使用libbpf和bpftool作为Git子模块)。 Go和C与Cilium ebpf、libbpfgo 当在Golang中编写eBPF应用程序的用户空间部分时,这是一个不错的选择。例如,当eBPF应用程序的用户空间部分是Kubernetes Operator或CRD控制器时,通常会使用Golang编写。 Cilium ebpf库是一个独立的纯Golang eBPF实用工具库,独立于Cilium项目的其他应用程序,比如Cilium Kubernetes CNI插件。libbpfgo是另一个此类eBPF实用函数库,用户空间Golang应用程序可以使用它来加载eBPF对象文件(从任何语言编译而来),附加到各种eBPF钩子点等等。 libbpfgo使用围绕我们在前一节中讨论的C语言libbpf库的Golang包装器调用,因此有可能支持更多最新的核心eBPF功能。Cilium eBPF库不是libbpf库的包装器,背后的社区略显多样化(相对于libbpfgo),包括供应商Isovalent和CloudFlare。 Rust and Rust with Aya Aya是一个用于BPF应用程序开发的纯Rust库,旨在与libbpf具有功能相当。与上文描述的Cilium eBPF库类似,Aya不包含围绕C语言libbpf库的包装函数。正如前面提到的,用于eBPF内核程序的编程语言和工具链与应用程序的用户空间程序所使用的语言和工具无关。我们将在未来的一篇文章中详细描述这个选项,届时我们将介绍Aya和bpfd项目。 eBPF应用程序跨平台开发、可移植性、CO-RE和内核API稳定性 最佳实践的eBPF应用程序开发从一开始就考虑了跨平台开发、可移植性和可维护性。最近的eBPF内核增强功能,比如CO-RE(编译一次,随处运行)大大改进了这一领域的开发体验。 图4显示了一个支持不同开发环境和不同目标系统的开发模型。开发环境使用了前面讨论的C与libbpf。 在图中,一个开发人员正在使用运行内核5.6的开发计算机,而另一位开发人员则使用内核5.10。这两位开发人员可以在两个不同的目标系统上进行测试,第一个目标系统运行带有内核5.2的Debian,而第二个目标系统运行Red Hat企业Linux,内核已升级到5.16版本。 直到最近,这种开发模型无法用于eBPF应用程序,特别是那些与在内核版本之间更改的原始内核数据类型和结构进行交互的应用程序。因此,eBPF应用程序必须在加载到目标系统时即时编译(使用其他加载功能,如BCC的内置CLANG/ LLVM)以获取实际目标系统内核的内核头文件和类型信息。 然而,被称为CO-RE(Compile Once Run Everywhere)的新eBPF基础架构使单个eBPF二进制对象能够在不同的内核版本上加载和运行,无需重新编译或复杂的解决方法。请参考本文及其附带的CO-RE指南,其中提供了有关CO-RE和开发人员最佳实践的出色详细信息。 推荐和要点 1. 在可能的情况下,使用支持CO-RE的eBPF加载器,该加载器支持基于内核数据类型的重定位能力。 本文前一节中讨论的3种应用程序堆栈选项都支持CO-RE。其他eBPF加载器选项,如BCC框架,目前不支持CO-RE。 2. 遵循CO-RE最佳实践。 这包括使用编译器/Clang属性,例如__attribute__((preserve_access_index)),以确保eBPF程序使用的内核数据类型的可重定位性,使用诸如BPF_CORE_READ()宏之类的助手,以有效地访问内核数据,即使有多层指针间接引用,以及使用CO-RE功能来以编程方式检测内核版本和内核配置信息,以处理更复杂的内核数据类型更改,如CO-RE指南中所述。 3. 考虑使用 vmlinux.h 来简化包含头文件,而不是开发系统中打包的内核头文件。 vmlinux.h文件是可以通过bpftool工具生成的文件,用于包括内核映像中的所有数据类型。这是一个方便的单个头文件,供eBPF程序从中包括,而不是一组广泛而有些特殊的内核头文件,可能会因开发人员的系统而异。我们建议创建此文件的精简版本,只包括应用程序实际需要的内核定义。这可以确保: 与目标内核版本的数据类型保持一致 可以充分利用CO-RE重定位 具有适当大小的头文件,更容易维护 4. 针对所有目标内核版本和相关子系统配置测试eBPF应用程序。 即使遵循所有CO-RE最佳实践,也很重要测试任何eBPF应用程序,测试所有或一组宽泛的内核版本以及相关内核子系统和模块配置的变化,以确保在所有目标部署中具有完全的可移植性和正确性。 5. 确定应用程序所需的最低内核版本。 首先,阅读BPF功能文档,以确定包含所需功能的内核版本范围。例如: cgroup/connect4程序支持是在4.17中添加的。 BPF有界循环是在5.3中添加的。 然后,您可以选择编写您的应用程序,仅使用内核版本中可用的eBPF函数,或者使用BPF功能探测来在运行时检测功能的可用性。 您的BPF程序可以检查内核版本: #include <bpf/bpf_helpers.h> extern int LINUX_KERNEL_VERSION __kconfig; int probe_kernel() { if (LINUX_KERNEL_VERSION > KERNEL_VERSION(4, 18, 0)) { /* 我们在支持的内核版本上 */ } else { /* 记录错误并优雅退出 */ } ... } 您的BPF程序还可以探测单个内核功能或结构定义: extern bool CONFIG_LWTUNNEL_BPF __kconfig __weak; if (CONFIG_LWTUNNEL_BPF) { /* 从BPF配置lwtunnel */ } if (bpf_core_type_exists(struct bpf_ringbuf)) { /* 使用ringbuf而不是perf缓冲区 */ } 运行中的BPF程序的架构 下图显示了用户空间应用程序及其嵌入式BPF程序的视图。该应用程序链接到libbpf,libbpf代表应用程序创建BPF映射并加载程序。 在此图中,我们可以看到BPF程序连接到网络数据路径中的tc钩子。用户空间应用程序和BPF程序共享访问由内核中的BPF子系统管理的映射。BPF程序还使用助手函数从其他内核子系统中访问数据。 使用libbpf的C应用程序示例 这里讨论的主题最好通过示例应用程序来演示。我们将使用DNS跟踪实用程序来突出显示主要要点。 libbpf-bootstrap为使用libbpf的C项目提供了一个很好的起点。在这里,我们通过复制libbpf-bootstrap的Makefile和项目布局,并根据自己的需求进行调整,创建了一个dns-trace实用程序项目: . ├── Makefile ├── dns-trace.bpf.c # BPF代码 ├── dns-trace.c # 用户空间代码 ├── dns-trace.h # 共享定义 ├── libbpf # libbpf git子模块 └── .output ├── dns-trace.skel.h # 骨架,由bpftool生成 └── vmlinux.h # 所有内核类型定义,由bpftool生成 共享定义 dns-trace实用程序有一个BPF部分,用于拦截DNS数据包,以及一个用户空间部分,用于解码DNS消息并报告各种指标。BPF程序捕获的数据以事件流的形式通过BPF环形缓冲区发送到用户空间程序。struct dns_event在BPF和用户空间程序中都被使用。请注意确保类型定义对两个编译单元都可以解析。 用户空间程序使用系统头文件,包括UAPI导出的内核类型,如__u32和libbpf头文件。 BPF程序也在包括生成的<vmlinux.h>时具有访问UAPI导出的内核类型的能力,同时还包括了所有内核类型定义。 任何要包括在两个编译单元中的结构都需要使用UAPI导出的内核类型并避免内核的内部类型定义。 struct dns_event { __u64 duration; char ifname[IFNAMSIZ]; __u32 srcip; __u32 dstip; __u16 length; unsigned char payload[MAXMSG]; __u16 id; __u16 flags; }; 访问内核数据结构 BPF程序连接到net_dev_queue内核跟踪点,以拦截主机上运行的任何程序发送或接收的所有数据包。跟踪点上下文包括一个指向保存数据包数据的struct sk_buff的指针。我们只对访问sk_buff->data和sk_buff->len字段感兴趣,因此我们可以使用CO-RE来访问它们。BPF程序定义了自己的struct sk_buff的私有版本,其中只包含我们需要的字段。该结构使用preserve_access_index属性进行注释,以便在加载BPF程序时进行CO-RE重定位。 struct sk_buff { unsigned char *data; unsigned int len; } __attribute__((preserve_access_index)); struct trace_event_raw_net_dev_template { struct sk_buff *skbaddr; } __attribute__((preserve_access_index)); 此项目本地的struct sk_buff定义清晰地说明了我们实际需要的结构的子集。C代码使用BPF_CORE_READ()宏来访问struct sk_buff字段,再次在加载BPF程序时启用CO-RE重定位到运行的内核。 SEC("tracepoint/net/net_dev_queue") int trace_net_packets(struct trace_event_raw_net_dev_template *ctx) { unsigned char *data = BPF_CORE_READ(ctx, skbaddr, data); unsigned int len = BPF_CORE_READ(ctx, skbaddr, len); do_trace(data, len); return BPF_OK; } 用户空间应用程序 用户空间应用程序通过生成的BPF程序骨架使用libbpf来加载BPF程序并访问BPF程序中定义的映射。骨架由项目Makefile中的bpftool gen skeleton生成。骨架派生自BPF程序,因此所有映射应该在BPF C代码中定义,然后通过用户空间代码中的骨架访问器引用。 生成的骨架提供了加载BPF代码和附加BPF程序的函数: /* Load and verify BPF object file */ skel = dns_trace_bpf__open(); if (!skel) { fprintf(stderr, "Failed to open and load BPF skeleton\n"); return 1; } /* Load & verify BPF programs */ err = dns_trace_bpf__load(skel); if (err) { fprintf(stderr, "Failed to load and verify BPF skeleton\n"); goto cleanup; } /* Attach tracepoints */ err = dns_trace_bpf__attach(skel); if (err) { fprintf(stderr, "Failed to attach BPF skeleton\n"); goto cleanup; } 从用户空间程序中设置和轮询BPF环形缓冲区所需的代码非常少: struct ring_buffer* ringbuf = ring_buffer__new(bpf_map__fd(skel->maps.dns_events), process_event, NULL, NULL); while (!exiting) { ring_buffer__poll(ringbuf, 100); } 应用程序使用与BPF程序共享的struct dns_event定义从BPF程序的环形缓冲区接收事件。 eBPF文档体系 BPF子系统和支持库拥有大量文档资源,但它们分散在不同的位置。以下是一些有用的链接,可帮助您访问最相关的文档: eBPF Foundation: eBPF文档 内核文档: BPF文档, BPF映射, 程序类型, BPF kfuncs 手册页: bpf-helpers, bpftool 库文档: libbpf, libxdp, Aya, Cilium ebpf 参考博客: BPF CO-RE参考指南 示例: libbpf-bootstrap, 实用BPF示例 需要注意的是,BPF领域没有单一的权威指南,而且仍有很多未记录的知识。 eBPF术语 BTF: BPF类型格式是一种用于存储有关Linux内核或BPF程序类型信息的紧凑编码。它用于通过BPF CO-RE实现BPF程序的可移植性。 CO-RE: BPF CO-RE(编译一次,到处运行)使得编写可在多个内核版本上运行的可移植BPF应用程序成为可能,无需修改或重新编译目标机器。 内核用户空间API(UAPI): UAPI是内核和用户空间之间的接口,由系统调用、头文件、sysfs、procfs、BPF辅助函数等组成。 译者注 原文来自 RedHat的博客 BPF application development: Beyond the basics 本文为机翻+人工矫正。 笔者的eCapture项目,用户空间加载器使用ebpfmanager类库,包装了cilium/ebpf类库,也是纯Go的加载器。在这里也推荐给大家。 2023-10-24 1 0
eCapture支持流量转发的进展同步 大家好,eCapture项目距上次新版发布也已经过去2-3个月了,在这期间,社区论坛里很多网友提了一些问题以及需求,等我来解决。这几个月博主工作特别忙,一直没时间更新eCapture。这个周末特地抽时间解决了社区中反应的一些bug、优化点等。至于新功能,主要的就是流量转发功能,这个功能还是比较复杂的。 今天,博主先把发布一个修复bug的版本,等过段时间博主不是那么忙了,再构思流量转发功能,分享给大家。 新版发布 功能介绍 增加了Linux 5.2一下内核的异常提示 移除了curl/wget等参数路径指定 恢复了关联数据包目标IP功能。 修复了Openssl FD总是为0的错误。 其中,第二条可能会有影响,移除curl\wget路径参数,也顺带移除了自动搜索这两个软件所使用的Openssl动态链接库版本,以及所属路径问题。意味着大家需要自己检查期望被捕获的程序所用的SSL类库版本,并手动使用--libssl参数指定。 下载 下载地址:eCapture v0.6.2 流量转发 流量转发功能有很多使用场景,包括测试、渗透、研发、运维等,国内外都有用户提到过这个需求。 流量转发功能,必不可少的数据就是IP五元组,而这个问题,是eCapture最头疼的问题,拿不到远程地址的IP、端口数据。 eCapture实现介绍 基于TC的流量包获取,使用Uprob eBPF来完成捕获捕获。借助于wireshark的pcapng模式,进行解析展示。 基于uprobe hook,eBPF程序挂钩到libssl动态链接库文件中,针对 SSL_write 、SSL_read函数进行Hook,读取其参数、返回值。 uprobe hook也就是函数的调用hook,意味着只有这个函数触发时,才能执行eBPF的程序。并且是没法调用外部的SSL的外部函数的。 int SSL_write(SSL *s, const void *buf, int num) { // eBPF uprobe return ret; // eBPF uretprobe } int SSL_read(SSL *s, void *buf, int num) { // eBPF uprobe return ret; // eBPF uretprobe } 比如,eBPF uprobe代码是插入到SSL_write函数的入口点,可以读取SSL *s、const void *buf、int num这三个参数。也就是说,这里并没有关于这个数据包所属IP、port等信息的参数。要想拿到IP等信息,必需从这三个参数里读取。 eCapture的数据包关联IP实现 eCapture的实现,是根据SSL *s 的内存地址,再根据结构体中的偏移地址进行二次定位、三次定位等,查找最终的目标数值。 但是,但是来了,SSL *s对应ssl_st结构体,里面并不存储IP\addr等信息 。现在的实现是读取SSL *s里的rbio\wbio结构体,他们里面有个num字段,也就是FD信息。 再hook connect函数, int __connect (int fd, __CONST_SOCKADDR_ARG addr, socklen_t len) 读取FD,以及addr信息存储到 eBPF manp里。 eCapture再根据进程PID、fd来关联addr信息。 这样的实现有个缺点,就是__connect函数一般都在libpthread.so里,意味着除了hook libssl.so,还需要再多hook一个动态链接库,而且在部分Linux发行版或者Android中,还不确定会被放到哪个链接库下。 缺陷 在SSL_read时,是可以正常工作的。但在SSL_write时,fd可能读到0,是因为SSL_write函数它可能是一个异步的BIO实现。 这就导致发送的包拿不到目标IP信息。 未来做数据包转发时,目标代理软件就无法解析、无法关联到一个TCP会话中。 难点 只好另寻其他办法。 但从libssl.so这一个文件来看,不管是Read还是Write函数,第一个参数是SSL *结构体,最好能从这个结构体中找到存储了远程IP端口的信息。但我读了很久的Openssl类库源码,也没找到哪里存了这个数据。 取舍 如果说,Hook一个函数的方式实现不了,只能回到前面的hook两个函数的方向上了。但区别是说,仍要保持只hook openssl这一个动态链接库,否则兼容成本太大。 目前有一些思路,比如SSL_set_fd函数等。 int SSL_set_fd(SSL *s, int fd) int SSL_set_wfd(SSL *s, int fd) int SSL_set_rfd(SSL *s, int fd) 需要确认的是,每个TCP链接,都必须要在绑定FD时,调用一次SSL_Set_fd,或者SSL_set_wfd、SSL_set_rfd等函数,而这个是无法单从openssl的代码能确定的,而是取决于使用openssl类库的程序,可控性就很差。 耐心等待 是的,又到了你看不见工作量的需求上了,又需要博主拼命肝功能了,等我好消息。 2023-09-25 3 0
GitHub万星项目进度70%,eCapture旁观者7K Stars达成 简述 是的,一年半时间,笔者的首个7000星的GitHub开源项目来了,它就是eCapture旁观者。未来一年,争取过万星。 项目背景 eCapture一个无需CA证书,无侵入的HTTPS/TLS明文抓包工具。可以在Linux 4.18以上版本使用,同时也支持Android arm64 5.5以上版本。 eCapture的中文名叫「旁观者」,即「当局者迷,旁观者清」,与其本身功能「旁路、观察」契合,且发音与英文有相似之处。此工具切入大家痛点,不需要CA证书,也不需要进程冲洗,就可以在Linux上分析生产环境的https网络包的问题,深受大家欢迎。 从2022年3月底创建,至今一年半时间,获得7000星。与知乎上较为出名的xmake-io/xmake开源项目相比,可谓神速。当然,个人的努力固然有,但主要是借助了历史的进程——eBPF技术兴起。 依赖技术 eBPF技术是Linux内核的子系统,用来做跟踪、抽样、网络优化、安全管控等。借助于eBPF的动态插桩能力,eCapture可以无需应用进程重启,无需CA证书,动态增加观测点,实现对进程的HTTPS/TLS加密通讯抽样诊断。 eCapture项目是用来做网络分析的,适合线上环境,不方便重启进程的场景。使用eBPF TC/uprobe HOOK技术,支持Linux/Android 系统,支持x86_64/aarch64两种CPU架构,工具大小不到10M。 支持保存为文本日志,以及pcap-NG格式文件,直接用wireshark打开分析。同时,还可以支持关联网络所属的进程名、进程PID等信息,在入侵对抗领域,特别需要后门网络包是哪个进程发出的,从而更好的定位后门进程。 迭代 从2022年3月起,至今发布了34个版本,160多个PR;整理了5篇文章,录制了3个视频。花费了100多瓶可乐,掉了几万根头发...... 时间与精力 大部份功能上,项目的规划、研发、测试、交付、运营对接,都是我一个人。时间上,几乎都是下班后的21点到凌晨1点,以及周末的大部分时间。也就是说,2022年的大部分休息时间都贡献给了eCapture这个开源项目。 一个人做开源,特别花时间、花体力,花精力,完全是用爱发电。 可以对比eCapture跟xmake两个项目的代码编写事件。 可能是因为eBPF技术比较偏内核底层,社区熟悉这部分技术的人不多,可以为项目贡献的人寥寥无几,整体参与度不高。在这里也非常感谢为eCapture做贡献的人。 展现在大家眼前的是一个软件,一个项目,帮你解决了一些问题。所需要代码行数并不多等,实际上,笔者需要花费大量时间、精力,研究学习背后的技术知识。 冰山的背后 比如Pcapng格式的支持,需要了解PcapNG File Format,了解里面Block的含义,如何解析、填充;了解Packet flow in Netfilter and General Networking,才能更好的选择HOOK点。深挖Decryption Secrets Block标准,并提交了google/gopacket PR # 1042,支持DSB格式,使得Wireshark可以直接分析eCapture捕获https加密包的明文内容。 比如Golang uretprobe,需要了解Golang在不同版本下的ABI规范,是基于寄存器,还是栈。符号表内,函数调用的参数传递顺序差异。函数调用栈与参数、返回值的内存布局等。只有了解这些,才能更好的实现函数入参、返回值的捕获,才能实现Golang的TLS类库密钥捕获,实现Golang TLS类库的加密通讯明文捕获。 比如Android系统的支持,需要了解AMD64、ARM64的兼容实现,了解Linux内核在Android上的调整点。探索在Linux上编译Android可运行的eBPF程序路线。翻阅对比Openssl类库封装成BoringSSL的差异,熟悉ELF文件装载、加载过程,定位合适的挂钩函数,确定内存偏移量,才能动态适配多种OpenSSL、BoringSSL类库,支持这些类库的TLS/SSL密钥捕获以及明文捕获。 除了技术实现,在推广运营上,笔者画了很多架构图、原理图,甚至自学视频制作,录制使用方法,学习视频剪辑、录音等等。虽然学习是痛苦的,但笔者的艺术细胞倒是提升不少。 你看到的只是海面上的成功部分,而实际上需要我付出的,却是冰川下大量的研发工作。 尽管如此,开源的路上依旧少不了质疑的人。 质疑 去年在知乎上有一偏讨论eBPF的评论,里面有一些臆测,认为eCapture就是一个木马后门,认为在敲击键盘那一刻,偷偷记录按键行为就可以实现。 还有人认为,作者是中国人,关注的公司也是腾讯、阿里、字节、清华大学这种中国的公司,脑海中确实又蠢又坏的猜忌。 人生的路上,少不了质疑与漫骂。对此我表示哈哈一笑。稍作回答:eBPF技术是正经技术,作者也是正经人。 展望 作为一个网络分析工具, eCapture的基本功能已经具备,在实际的分析场景中,希望能像tcpdump、Charles等工具一样,可以保留相同的参数习惯,以及结合这些工具一起使用。 为此,笔者规划两项功能,以及增强社区运营,推动eCapture进入到部分Linux发行版的软件源上。 Charles Proxy\Burp Suite可读的网络包文件 支持tcpdump的filter表达式 进入Linux发行版的软件源仓库 最初,项目是靠GitHub自己的推荐功能,吸引了很多关注者。之后为了让用户能快速上手,也写了很多文章,画各种原理图、架构图,制作各种使用的演示视频,这也特别花时间、精力。面向用户也是国内跟国外,语言是汉字与英语,所以还做了多语言的版本,对于英语渣的我来说,挑战也极大。 一路走来,感受颇多。项目传播速度,跟我精力的分配息息相关。从去年下半年起,笔者工作上特别忙,投入到这项目的时间逐渐减少。从热情澎湃时的每天晚上24点提交代码,到后来每周周末提交代码,甚至现在一个多月才提交几次代码。精力实在有限。 笔者期望,eCapture能为大家带来更大的帮助,期望大家也能一起参与进来。 一个人走得很快,但一群人走得更远。 当然,也不排除,未来捐献给类似CNCF之类的开源组织。但也要在笔者的这个万星目标之后考虑。万星项目,冲冲冲。 扩展阅读 为了方便新人上手,笔者曾录制过几篇视频,也整理过一些文章介绍,对eCapture不熟悉的同学可以读读。 eCapture旁观者:Android HTTPS明文抓包 eCapture:无需CA证书抓https网络明文通讯(Linux) eCapture支持bogingssl TLS 1.3明文捕获 Linux中基于eBPF的恶意利用与检测机制 Tetragon进程阻断原理 2023-08-28 0 0
eBPF挂钩TC egress时,被TCP Checksum搞死了 译者注 我最近也在尝试用eBPF TC类型程序,挂钩egress网络包,修改IP包、TCP包内容,实现路由跟踪的功能。除了eBPF验证器的奇葩问题外,剩下的就是skb_buff修改后,被客户端内核丢弃、中间路由丢弃、服务端内核丢弃的各种问题,头发那是一把一把的掉。幸运的是,我找到了这篇文章Checksum-or-fxxk-up,写的特别好。看标题就知道作者被折腾不清,这点我感同身受。 TL;DR 如果你不想自讨苦吃,就千万别对checksum进行任何不当操作。但如果你想看到一个反面教材,继续阅读这篇由我这个不称职的人写的记录。 背景 我有一个挂钩在 ingress TC BPF程序,可以修改某些传入数据包的IP头部和TCP标志中的几个位。它在功能上表现得非常出色。直到... dmesg 异常日志 在测试程序时,在dmesg中发现了以下消息: [1216218.835883] <unknown>: hw csum failure [1216218.843767] CPU: 11 PID: 3627719 Comm: ThriftIO15 Not tainted 4.16.18-210_fbk23_5358_gf2838c074351 #210 [1216218.862917] Hardware name: Quanta Twin Lakes MP/Twin Lakes Passive MP, BIOS F09_3A12 10/08/2018 [1216218.880669] Call Trace: [1216218.885910] <IRQ> [1216218.890287] dump_stack+0x46/0x68 [1216218.897272] __skb_checksum_complete+0xb0/0xc0 [1216218.906516] tcp_v6_do_rcv+0x12b/0x3d0 [1216218.914370] tcp_v6_rcv+0xad0/0xb00 [1216218.921701] ip6_input_finish+0xbf/0x460 [1216218.929903] ip6_input+0x80/0x90 [1216218.936714] ipv6_rcv+0x358/0x4c0 [1216218.943698] ? tcf_classify+0x87/0x120 [1216218.951551] __netif_receive_skb_core+0x541/0xa40 [1216218.961315] netif_receive_skb_internal+0x24/0xb0 [1216218.971080] napi_gro_receive+0xba/0xe0 [1216218.979105] mlx5e_handle_rx_cqe+0x83/0xd0 [1216218.987649] mlx5e_poll_rx_cq+0xc8/0x920 [1216218.995840] mlx5e_napi_poll+0xa1/0xc30 [1216219.003866] net_rx_action+0x128/0x340 [1216219.011718] __do_softirq+0xd4/0x2ad [1216219.019219] irq_exit+0xa5/0xb0 [1216219.025850] do_IRQ+0x7d/0xc0 [1216219.032132] common_interrupt+0xf/0xf [1216219.039798] </IRQ> 我是如何陷入checksum深渊的。 根因与解决方案 这条消息显示出现了checksum错误。我让tcpdump重新检查,但他说checksum是正确的。然后我意识到入口TC BPF程序在tcpdump之后、内核接收数据包之前运行。这可以解释为什么tcpdump在checksum方面没有问题,而内核却报错。 根本原因很明确:入口BPF程序在TCP/IP头部篡改了位,但没有修复checksum。解决方案似乎也很简单:修复checksum就好了。 嗯,我将为我们节省一些时间,不再抱怨在一大堆与checksum相关的API中查找解决方案时的痛苦,比如bpf_l3_csum_replace、bpf_l4_csum_replace、bpf_csum_diff和bpf_csum_update。 更令人沮丧的是,最后一个简单的BPF_F_RECOMPUTE_CSUM标志传递给bpf_skb_store_bytes(用于修改位)就解决了问题。 checksum工作原理 在深入了解更多细节之前,让我们来看看checksum的工作原理。下面的图示非常好地阐述了这一点。(图片版权:Error Detection in Computer Networks) 为了避免混淆,在这篇文章中,我将使用术语“csum”来指代上图中的“sum”,并使用术语“checksum”来指代“csum”的1's补码。正如你所看到的,只要数据没有被篡改,~(csum + checksum) == 0。 还有一个谜题 在调试过程中,我发现了一件有趣的事情 - 尽管错误被打印出来,但数据包并没有被丢弃,因此处理过程继续进行。为什么会这样呢? 由于上面的堆栈跟踪中没有显示某些内联函数,所以我将在这里“展开”调用堆栈的逻辑: tcp_v6_do_rcv() { // Checking checksum is unnecessary if (skb_csum_unnecessary(skb)) { nothing; } else { // Re-do checksum for whole skb csum = skb_checksum(skb, 0, skb->len, 0); // Check csum against skb->csum. If skb is intact, sum should be 0 sum = csum_fold(csum_add(skb->csum, csum)); if (sum == 0) Print "hw csum failure" to dmesg and dump stack trace else Checksum fails, throw the skb away } // Continue processing skb } 当打印错误时,必须满足以下条件: skb_csum_unnecessary返回false。 如果我们计算skb的checksum并将其与skb->csum进行比较,应该通过。也就是说,csum_add(skb->csum, skb_checksum(skb))应该返回零。 当skb_csum_unnecessary返回false时,意味着skb->csum_valid为false,这反过来又意味着在skb_checksum_init期间未将skb->csum_valid设置为1。这是因为原始的skb->csum和psum不相加得到零。还要注意,在skb_checksum_init之后,将skb->csum设置为psum。 说人话就是: 如果我正在运行,则表示检查硬件(NIC)提供的 skb-> csum 与 psm (稍后会讨论) 的一致性检查失败了。去你妈的硬件!(打印错误)但你知道吗?我重新计算了 skb 的checksum,并且它确实正确无误。让我们忘记硬件错误继续前进吧! 毫无疑问,硬件是清白的,罪魁祸首是我的 BPF 程序。所以即使数据包没有被丢弃,并且连接没有受到影响,我仍然修复了有罪的 BPF 程序来证明硬件的清白。 当我庆祝又一个结案时,我不知道罪犯正在干什么。 checksum又TM搞事情? 在部署BPF程序时,我发现一旦程序被attach,InCsumErrors就会不断增加。 $ netstat -s | grep InCsumErrors InCsumErrors: 101 继续调试 我不能谈论内核调试而不提到我的好朋友 - bpftrace。这一次,再次借助它的帮助,我能够将问题缩小到以下堆栈: __skb_checksum_complete+1 tcp_v6_do_rcv+293 tcp_v6_rcv+2762 ip6_input_finish+186 ip6_input+128 ipv6_rcv+853 __netif_receive_skb_core+1312 netif_receive_skb_internal+36 napi_gro_receive+183 mlx5e_handle_rx_cqe+125 mlx5e_poll_rx_cq+194 mlx5e_napi_poll+161 net_rx_action+290 __softirqentry_text_start+207 irq_exit+165 do_IRQ+119 ret_from_intr+0 cpuidle_enter_state+176 do_idle+260 cpu_startup_entry+25 secondary_startup_64+165 堆栈与之前的问题相同。然而,这次在dmesg中没有错误消息,并且数据包被丢弃,导致了重传。在tcpdump中,我看到的是以下序列: 一个TCP SYN数据包到达,但没有收到SYN-ACK。 一秒钟后,重新发送的SYN数据包到达并收到了SYN-ACK。 连接成功建立。 老天保佑 在浏览内核代码数小时后,我决定采用一种不太科学但有效的调试方法 - 尝试不同的事物,希望能找到一个可行的解决方案,并祈求上天提高成功率。 然后我注意到问题只发生在修改TCP头部时。即使使用BPF_F_RECOMPUTE_CSUM在修改后相应地修复了skb->csum。我决定看一下如果在修改TCP头部后不修复skb->csum会发生什么。而且,令人惊讶的是,它起作用了! 以下表格显示了我尝试过的事情及其结果: 至少有两个问题出现在这个表格中: 如果不重新计算IP头部更改的checksum,为什么会出现hw csum failure? 如果重新计算TCP头部更改的checksum,为什么会出现TcpInCsumErrors? 下一个目标是回答这两个问题,并确保我发现了解决方案而不是巧合。 寻找答案 TcpInCsumErrors错误发生是因为skb_checksum_init返回非零值。调用堆栈有点复杂。所以让我们再次简化逻辑(省略了无关的代码)。 这是我见过的最复杂的代码之一。 我在上述代码中标记了两个错误情况。我们需要非常小心地处理逻辑,以避免在处理checksum时出现这两个错误。 ip6_compute_pseudo 是什么? 它计算 TCP 伪头部的checksum。结果就是我们之前看到的 psum。(图片来源:[TCP Checksum Calculation and the TCP "Pseudo Header"](http://www.tcpipguide.com/free/t_TCPChecksumCalculationandtheTCPPseudoHeader-2.htm "TCP Checksum Calculation and the TCP "Pseudo Header"")) 触发“hw csum failure”的条件如下: ~(psum + skb->csum) != 0,即检查skb->csum与psum的校验失败。 ~(skb_checksum(skb, 0, skb->len, 0) + psum) == 0,即对skb新计算的checksum与psum进行校验通过。 触发“TcpInCsumErrors”的条件如下: ~(psum + skb->csum) != 0,即检查skb的checksum与psum的校验失败。 ~((skb_checksum(skb, 0, skb->len, 0) + psum) != 0,即对skb新计算的checksum与psum进行校验也失败。 有些奇怪 你可能注意到了一些奇怪的地方。skb->csum与psum(伪头部的checksum)进行了比较。为什么会这样呢?难道不应该使用类似于~(skb->csum + checksum(skb)) == 0这样的方式,将其与整个skb的checksum进行比较吗? 我会尽力解释一下。关键在于,就像上面显示的图表所示,TCP头部也有一个checksum。 计算TCP头部checksum的公式是 tcp_hdr_checksum = ~(pseudo_hdr + tcp_hdr_with_checksum_0) 注意: 我将使用“+”来表示“csum add”,这个算法将展示“checksum是如何工作的?”部分的图表中。 payload被故意省略,因为它并不重要。 skb->csum 是由NIC使用整个数据包计算得出的16位checksum。即, skb->csum = ip_hdr + tcp_hdr 注意: 在进行csum add时,IP头和TCP头都会被切片,然后将它们的16位块相加/折叠在一起。 因为IP头、伪头部和TCP头都是16位对齐的,所以这两个公式可以重新写成 tcp_hdr_checksum = ~(pseudo_hdr_0_15 + pseudo_hdr_16_31 + ... + tcp_hdr_0_15 + tcp_hdr_16_31 + ... + 0x0000 (checksum) + ...) 如果我们在两边都进行~操作,我们得到 ~tcp_hdr_checksum = pseudo_hdr_0_15 + pseudo_hdr_16_31 + ... + tcp_hdr_0_15 + tcp_hdr_16_31 + ... + 0x0000 (checksum) + ... 然后我们在两端添加tcp_hdr_checksum: ~tcp_hdr_checksum + tcp_hdr_checksum = pseudo_hdr_0_15 + pseudo_hdr_16_31 + ... + tcp_hdr_0_15 + tcp_hdr_16_31 + ... + tcp_hdr_checksum + ... 因为我们知道 ~tcp_hdr_checksum + tcp_hdr_checksum = 0xFFFF。所以 pseudo_hdr_0_15 + pseudo_hdr_16_31 + ... + tcp_hdr_0_15 + tcp_hdr_16_31 + ... + tcp_hdr_checksum + ... = 0xFFFF 因此 tcp_hdr_0_15 + tcp_hdr_16_31 + ... + tcp_hdr_checksum + ... = 0xFFFF - (pseudo_hdr_0_15 + pseudo_hdr_16_31 + ... ) = 0xFFFF - psum 我们可以将这个插入到skb->csum中。 skb->csum = ip_hdr_0_15 + ip_hdr_16_31 + ... + tcp_hdr_0_15 + tcp_hdr_16_31 + ... + tcp_hdr_checksum + ... = ip_hdr_0_15 + ip_hdr_16_31 + ... + 0xFFFF - psum 记住这个公式,我会回答上面的两个问题。 为什么在不重新计算IP头更改的情况下会出现“hw csum failure”? (为简单起见,假设TCP头部未被修改。) 在内核网络堆栈中,在处理IP头部之后,它的checksum会从skb->csum中提取出来或者减去。然后skb->csum就变成了 skb->csum = (ip_hdr_0_15 + ip_hdr_16_31 + ... + 0xFFFF - psum) - (ip_hdr_0_15 + ip_hdr_16_31 + ...) = 0xFFFF - psum 现在我们知道为什么在skb_checksum_init函数中,要将skb->csum与psum进行比较 - 因为它是公式中唯一剩下的变量。 然而,如果IP头部发生了改变(比如说,ip_hdr_16_31中的几个位被翻转),但是skb->csum没有相应地改变,那么它就会变成这样。 skb->csum = skb->csum - (ip_hdr_0_15 + ip_hdr_16_31 + ...) = (ip_hdr_16_31 - ip_hdr_16_31) + 0xFFFF - psum 第一个条件 ~(psum + skb->csum) != 0或者(psum + skb->csum) != 0xFFFF。而数学计算如下: psum + skb->csum = psum + (ip_hdr_16_31 - ip_hdr_16_31) + 0xFFFF - psum = (ip_hdr_16_31 - ip_hdr_16_31) + 0xFFFF 结果显然不是0xFFFF。因此第一个条件已满足。 第二个条件 ~(skb_checksum(skb, 0, skb->len, 0) + psum) == 0或者skb_checksum(skb, 0, skb->len, 0) + psum == 0xFFFF。 skb_checksum(skb, 0, skb->len, 0) 是用于重新计算 skb 的checksum,此时 skb 只包含 TCP 头部。这将会 skb_checksum(skb, 0, skb->len, 0) = tcp_hdr_0_15 + tcp_hdr_16_31 + ... + tcp_hdr_checksum + ... = 0xFFFF - psum 因此 skb_checksum(skb, 0, skb->len, 0) + psum = 0xFFFF - psum + psum = 0xFFFF 第二个条件也得到满足。问题已经得到回答。 为什么在重新计算TCP头部checksum时会出现“TcpInCsumErrors”? (为简单起见,假设TCP头未被更改。) 请注意,当我们使用BPF_F_RECOMPUTE_CSUM时,它只会更新skb->csum而不会更新tcp_hdr_checksum。假设tcp_hdr_0_15中的几个位被翻转了。当调用skb_checksum_init时,实际上是在使用skb->csum。 skb->csum = tcp_hdr_0_15 + tcp_hdr_16_31 + ... + tcp_hdr_checksum + ... = tcp_hdr_0_15 - tcp_hdr_0_15 + tcp_hdr_0_15 + tcp_hdr_16_31 + ... + tcp_hdr_checksum + ... = tcp_hdr_0_15 - tcp_hdr_0_15 + 0xFFFF - psum 第一个条件 “TcpInCsumErrors”的判断条件为~(psum + skb->csum) != 0 或者 (psum + skb->csum) != 0xFFFF。所以数学计算如下: psum + skb->csum = psum + tcp_hdr_0_15 - tcp_hdr_0_15 + 0xFFFF - psum = tcp_hdr_0_15 - tcp_hdr_0_15 + 0xFFFF 结果显然不是0xFFFF。因此第一个条件已满足。 第二个条件 “TcpInCsumErrors”的~(skb_checksum(skb, 0, skb->len, 0) + psum) != 0或者skb_checksum(skb, 0, skb->len, 0) + psum != 0xFFFF。 skb_checksum(skb, 0, skb->len, 0) 是重新计算 skb 的checksum。它将与 skb->csum 相同,因此数学上与第一个条件相同。换句话说,第二个条件也满足。 正如你所看到的,如果我们在更新tcp_hdr_0_15时不修复skb->csum,那么第一个条件将无法满足,代码将直接从快乐结局路径返回。 等一下,这不是一个黑客行为吗? 是的,我同意。更新TCP头部但不更新其checksum和skb->csum听起来像个黑客行为。另一种选择是: 更新TCP头部中的位。 更新skb->csum以反映位变化。 更新TCP校验字段以反映位变化。 更新skb->csum以反映TCP checksum的变化。 通过这种方式,TCP头部的差异和TCP checksum的差异相互抵消。数学计算如下: skb->csum = tcp_hdr_0_15 + tcp_hdr_16_31 + ... + tcp_hdr_checksum + ... = tcp_hdr_0_15 - tcp_hdr_0_15 + tcp_hdr_0_15 + tcp_hdr_16_31 + ... + tcp_hdr_checksum - tcp_hdr_checksum + tcp_hdr_checksum + ... = (tcp_hdr_0_15 - tcp_hdr_0_15) + (tcp_hdr_checksum - tcp_hdr_checksum) + 0xFFFF - psum = 0xFFFF - psum 既然结果与根本不触碰skb->csum相同,为什么不直接使用这个技巧呢? 要点 如果可以的话,请不要搞乱checksum。 发明checksum的人是一个天才。 我是个傻X。 2023-07-24 0 0
golang uretprobe的崩溃与模拟实现 前言 在eCapture最初支持golang的https明文捕获时,是不支持request\response完整的匹配的。这点不同于C语言编写的程序,是因为golang的uretprobe类型钩子有个较为致命的bug,会导致被挂载进程崩溃,这问题在BCC社区也有讨论过:Go crash with uretprobe #1320, 火焰图作者brendangregg也提到,在他的一篇博客里,用户评论如下: Another problem I ran into: the uretprobe seems to place the return probes by modifying the stack, which is in conflict with how Go manages stack (stacks in Go can grow/shrink at anytime, it does so by copying entire stack to a new larger area, adjusting the pointers in the stack to point to new area etc). So if we are doing a uretprobe, and stack happens to grow (or shrink) at that time, it can lead Go runtime panics. Please see here for an example panic message:go.stp#L32-L58 也就是说 uretprobe似乎通过修改堆栈来放置返回探针,这与Go管理堆栈的方式冲突(Go中的堆栈可以在任何时候增长/缩小,它通过将整个堆栈复制到一个新的较大区域,调整堆栈中的指针以指向新区域等方式实现)。因此,如果我们正在进行uretprobe操作,并且堆栈在此期间发生增长(或缩小),它可能导致Go运行时发生错误。请参阅此处的示例错误消息:go.stp#L32-L58 亲自验证 是的,笔者在为eCapture增加go tls的明文捕获时,也是attach到Go 函数的uretprobe上,结果自然是,被挂载的进程崩溃了。经过漫长的debug、查资料,终于有点眉目。这其实跟Golang的runtime、寄存器等实现机制有关,我写了一个DEMO,验证一番。 这个DEMO是我在5月初写的,期间一直想写篇简单的文章给大家介绍一下,奈何太忙了,接着这次出差的机会,周末整理一下,分享给大家。时间相隔太久,可能很多细节都忘记了,笔者水平有限,如有错误,欢迎指出。 golang uretprobe冲突 话不多说,Go程序崩溃的核心原因为Go的栈在runtime管理时,被插入了异常的内存地址。Go中常见的堆栈变化为协程goroutine的创建与销毁。栈内 被插入异常内存地址是因为eBPF的实现机制是向函数的返回地址前,插入了断点指令(i386和x86_64是INT3)。 两个条件的叠加,就出现了这个错误。 那么重现起来也比较简单,写一个协程goroutine数量不停变化的程序,并使用eBPF uretprobe挂载上去即可。 案例演示 被HOOK的测试代码 package main import ( "flag" "fmt" "time" ) //go:noinline func recursion(level, maxLevel int) int { if level > maxLevel { return level } return recursion(level+1, maxLevel) } //go:noinline func NewTestFunc() int { //nothing print("NewTestFunc\n") return 100 } // uretprobe挂载的目标函数 // //go:noinline func CountCC(maxLevel int) (a int) { a = NewTestFunc() fmt.Println(a) if a > 100 { return a } a = recursion(0, maxLevel) fmt.Printf("CountCC return :%d\n", a) return a } func main() { var maxLevel = flag.Int("l", 100, "max recursion level") flag.Parse() for { go CountCC(*maxLevel) time.Sleep(time.Second) } } 被挂载的函数是CountCC,他的返回值应该是101,这段代码被Go编译后,CountCC在符号表里名字是main.CountCC,这个就是eBPF挂载的函数名。 要注意,在代码里务必使用go:noline语法来让Go编译器不要对这段代码进行内联inline,否则编译后的可执行文件中,符号表内就找不到main.CountCC函数了。 执行挂载动作的代码 内核空间代码: SEC("uretprobe/countcc") int uretprobe_countcc(struct pt_regs *ctx) { bpf_printk("new countCC[RET] detected\n"); return 0; }; 其中SEC的参数uretprobe/countcc在编译为ebpf字节码后,会被用户空间程序读取,关联到uretprobe_countcc这个符号上。 用户空间代码: 执行挂载动作的代码,也很好实现,使用笔者的golang eBPF管理SDK ebpfmanager,只需要几行代码,以下为用户空间程序: const COUNT_CC_SYMBOL = "main.CountCC" var sec = "uretprobe/countcc" var ebpfFunc = "uretprobe_countcc" var m = &manager.Manager{ Probes: []*manager.Probe{ { Section: sec, EbpfFuncName: ebpfFunc, AttachToFuncName: COUNT_CC_SYMBOL, BinaryPath: goAppPath, }, }, } // Initialize the manager buf, err := Asset("/probe.o") if err != nil { log.Fatal(errors.New(fmt.Sprintf("error:%v , couldn't find asset", err))) } if err = m.Init(bytes.NewReader(buf)); err != nil { log.Fatal(err) } // Start the manager if err = m.Start(); err != nil { log.Fatal(err) } 挂载类型uretprobe/countCC,被Go的eBPF类库解析为uretprobe类型程序。挂载的eBPF执行函数为uretprobe_countcc,挂载目标符号为main.CountCC。 执行重现 编译后,观测程序是main,被观测程序是demo。 启动观测程序bin/main 启动被观测程序bin/demo 崩溃栈信息 可以看到被观测程序立刻崩溃,崩溃的信息如下: bin/demo NewTestFunc 100 runtime: unexpected return pc for main.CountCC called from 0x7fffffffe000 stack: frame={sp:0xc000069f50, fp:0xc000069fc8} stack=[0xc000069000,0xc00006a000) 0x000000c000069e50: 0x000000c0000560d8 0x000000c0000140b8 0x000000c000069e60: 0x000000c000069e80 0x000000000048802b <main.recursion+0x000000000000002b> 0x000000c000069e70: 0x000000000047a0a0 <internal/poll.(*FD).Write.func1+0x0000000000000000> 0x000000c0000560c0 0x000000c000069e80: 0x000000c000069ea0 0x000000000048802b <main.recursion+0x000000000000002b> 0x000000c000069e90: 0x0000000000468efe <sync.(*Pool).pin+0x000000000000001e> 0x000000c0000560c0 0x000000c000069ea0: 0x000000c000069ec0 0x000000000048802b <main.recursion+0x000000000000002b> 0x000000c000069eb0: 0x000000000052e3c0 0x0000000000000000 0x000000c000069ec0: 0x000000c000069ee0 0x000000000048802b <main.recursion+0x000000000000002b> 0x000000c000069ed0: 0x000000000047d76a <fmt.(*pp).free+0x00000000000000ca> 0x000000000052e3c0 0x000000c000069ee0: 0x000000c000069f00 0x000000000048802b <main.recursion+0x000000000000002b> 0x000000c000069ef0: 0x000000c000036740 0x000000000047dc4e <fmt.Fprintln+0x000000000000008e> 0x000000c000069f00: 0x000000c000069f20 0x000000000048802b <main.recursion+0x000000000000002b> 0x000000c000069f10: 0x0000000000000004 0x000000000000000c 0x000000c000069f20: 0x000000c000069f40 0x000000000048802b <main.recursion+0x000000000000002b> 0x000000c000069f30: 0x0000000000000000 0x0000000000000000 0x000000c000069f40: 0x000000c000069fb8 0x0000000000488147 <main.CountCC+0x0000000000000087> 0x000000c000069f50: <0x00000000004c0798 0x000000c00000e018 0x000000c000069f60: 0x000000c0000367a8 0x0000000000000001 0x000000c000069f70: 0x0000000000000001 0x0000000000000000 0x000000c000069f80: 0x0000000000000000 0x0000000000000064 0x000000c000069f90: 0x0000000000000064 0x0000000000000000 0x000000c000069fa0: 0x0000000000000000 0x0000000000490180 0x000000c000069fb0: 0x0000000000528bc0 0x000000c0000367d0 0x000000c000069fc0: !0x00007fffffffe000 >0x0000000000000000 0x000000c000069fd0: 0x0000000000000000 0x000000000045bd81 <runtime.goexit+0x0000000000000001> 0x000000c000069fe0: 0x0000000000000000 0x0000000000000000 0x000000c000069ff0: 0x0000000000000000 0x0000000000000000 fatal error: unknown caller pc runtime stack: runtime.throw({0x4a2fba?, 0x522940?}) /usr/local/go1.18.8/go/src/runtime/panic.go:992 +0x71 runtime.gentraceback(0x423d45?, 0x7f46d2dc2fff?, 0x1?, 0x400?, 0x0, 0x0, 0x7fffffff, 0x4a92e0, 0x7f46d2dc2fff?, 0x0) /usr/local/go1.18.8/go/src/runtime/traceback.go:258 +0x1c2a runtime.copystack(0xc000003860, 0x800000002?) /usr/local/go1.18.8/go/src/runtime/stack.go:930 +0x2f5 runtime.newstack() /usr/local/go1.18.8/go/src/runtime/stack.go:1110 +0x497 runtime.morestack() /usr/local/go1.18.8/go/src/runtime/asm_amd64.s:547 +0x8b 其中致命的错误信息是fatal error: unknown caller pc,是的,重现了。 Go程序uretprobe挂载解决方案 冲突点 正如前文所说,这是golang 协程收缩容,导致stack变动, int3指令执行后,添加到stack中,破坏原来的栈,执行报错。如何解决这个问题呢,在之前的issue里,有人提了一个用uprobe模拟uretprobe的思路。 给定一个Golang二进制文件,解析ELF符号表并获取我们想要跟踪的符号的地址。如果需要,在该地址附加一个uprobes。 不要将uretprobe附加到符号地址,而是从该地址开始读取ELF文本部分,并解码汇编指令,直到达到符号的结束。在扫描过程中,在每个返回过程的指令(例如对于x86-64,RETN指令,操作码为0xC2和0xC3)处放置一个uprobes。对于我感兴趣的符号,通常只有很少的RET指令,大约在1到5个范围内,这是合理的。 当在上述点安装的任一uprobes触发时,实际上就像我们执行了一个uretprobe一样,除了我们没有干扰堆栈,因此当Go运行时移动堆栈时,解决方案足够稳健以避免崩溃(至少看起来是这样)。而且,由于uprobes恰好放置在RET指令之前,栈指针已经方便地放置在帧的开头,因此我们可以轻松访问输入参数和返回值,因为它们在Go中都存储在栈上。 评论者还提到,这种方法具有一些轻微的性能优势,因为我们避免了uretprobe的开销。但缺点是我们现在必须在用户空间中解码ELF文件的汇编指令,所以相比标准的替代方案要麻烦得多,而且,无法使用BCC之类工具,只能自己实现eBPF程序。 Go函数的RET偏移地址 这可难不到我,笔者一直不太用BCC,更喜欢自己写eBPF程序。实现起来也很简单,只需要按照DWARF Debugging Standard规范,读取Golang的ELF文件,查找符号表内对应main.CountCC函数对应符号的汇编指令,并按照X86格式解析,循环判断是否为RET,并记录当前指令在整个函数符号的偏移地址即可。 goElf, err = elf.Open(elfPath) // ... goSymbs, err = goElf.Symbols() // ... var found bool var symbol elf.Symbol for _, s := range goSymbs { if s.Name == symbolName { symbol = s found = true break } } section := goElf.Sections[symbol.Section] var elfText []byte elfText, err = section.Data() // ... start := symbol.Value - section.Addr end := start + symbol.Size var instHex []byte instHex = elfText[start:end] for i := 0; i < len(instHex); { inst, err := x86asm.Decode(instHex[i:], 64) // ... if inst.Op == x86asm.RET { offsets = append(offsets, i) } i += inst.Len } 内核空间程序 因为是用uprobe来模拟uretprobe,eBPF内核代码肯定要调整的了,为了要验证能否拿到返回值,这里也增加了返回值的获取。 SEC("uprobe/countcc") int uprobe_countcc(struct pt_regs *ctx) { bpf_printk("new countCC detected\n"); int num; num = (int)GO_PARAM1(ctx); bpf_printk("countCC :: num:%d, ret_num:%d\n", num); return 0; }; 可以看到,这里新增一个函数uprobe_countcc,将用于用户空间的eBPF执行函数。 用户空间程序调整 经过ELF文件分析,将RET指令的偏移地址保存到offsets中,在用户空间挂载到函数的偏移位置上: sec = "uprobe/countcc" ebpfFunc = "uprobe_countcc" m.Probes = m.Probes[:0] // 清空slice for _, offset := range offsets { m.Probes = append(m.Probes, &manager.Probe{ Section: sec, UprobeOffset: uint64(offset), EbpfFuncName: ebpfFunc, AttachToFuncName: COUNT_CC_SYMBOL, BinaryPath: goAppPath, UID: fmt.Sprintf("%s_%d", ebpfFunc, offset), }) } 可以看到Section改成了uprobe/countcc, 并挂载到内核函数uprobe_countcc上。以及新增 UprobeOffset字段,并设定offset,这样就实现自动的uprobe偏移量挂载。(PS:你就说,笔者的 ebpfmanager方便不方便吧) 模拟验证 按照之前的步骤,先启动观测程序,打开内核调试的日志,再启动被观测程序: 启动观测程序,bin/main -e,这里多了-e参数,来使用模拟模式。 打开内核调试日志,方便观察是否能拿到main.CountCC函数的返回值,命令为cat /sys/kernel/debug/tracing/trace_pipe。 启动被观测程序,bin/demo 观测程序 观测程序启动后,可以看到终端日志中,搜索到两处RET指令,并分别进行uprobe`挂载。 root@vm-server-2004:/home/cfc4n/project/go_uretprobe_demo# bin/main -e 2023/06/11 23:49:18 Github repo : https://github.com/cfc4n/go_uretprobe_demo 2023/06/11 23:49:18 Use uprobe+offset address instead of uretprobe:true 2023/06/11 23:49:18 traced ELF file:/home/cfc4n/project/go_uretprobe_demo/bin/demo 2023/06/11 23:49:18 attach function: main.CountCC 2023/06/11 23:49:18 Golang uretprobe hook main.CountCC [RET] at 0x7A 2023/06/11 23:49:18 Golang uretprobe hook main.CountCC [RET] at 0xE3 2023/06/11 23:49:18 successfully started, head over to /sys/kernel/debug/tracing/trace_pipe main.CountCC函数内,RET汇编指令的偏移地址分别为0x7A、0xE3 ,且都挂载成功,执行的内核函数为uprobe_countcc。 被观察程序 如你所见,被观测程序没有崩溃,可以正常运行,并输出结果。 bin/demo NewTestFunc 100 CountCC return :101 NewTestFunc 100 CountCC return :101 NewTestFunc 100 CountCC return :101 观察结果 笔者的DEMO里没有将内核调试结果传输到用户空间,直接打印了。 root@vm-server-2004:/home/cfc4n# cat /sys/kernel/debug/tracing/trace_pipe demo-18960 [000] .... 5125.277053: 0: new countCC detected demo-18960 [000] .... 5125.277089: 0: countCC :: num:101, ret_num:0 demo-18962 [001] .... 5126.276907: 0: new countCC detected demo-18962 [001] .N.. 5126.276940: 0: countCC :: num:101, ret_num:0 可以看到,demo-18960 (程序名+PID)运行结果后,出现了我们打印的日志。并且,捕获的结果是101,符合预期。 总结 eBPF挂载uretprobe崩溃的问题,只在Golang程序上发生,这跟Golang的协程缩容、扩容机制有关,受到CPU中断指令插入影响,破坏原有调用栈,导致问题发生。其他编译型语言上,不会有这个问题。假如有的语言也跟Golang一样,使用stack来做运动时管理,哪也会遇到这个问题。 关于 Golang的这个问题,在其社区里也有关于runtime: fatal error: unknown caller pc when uprobes are attached #27077的讨论,Go语言开发者aclements认为,这不是Go的问题,近期也不会考虑修复,希望uretprobe的管理层面,自动做返回地址栈的修复。 感谢提供的参考资料,@sillyousu。这些资料确认了我的猜测,很不幸地,我们实际上无法有效地解决uretprobes损坏堆栈的问题。 既然我们无能为力,而且这并不是一个Go的错误,我决定关闭这个问题。如果将来uretprobes能够提供足够的信息来恢复用户空间中被破坏的返回地址,我们可以重新考虑这个问题,并可能找到解决方法。 所以,这个问题,大家还是自己使用模拟的方法来解决Golang程序的函数返回值观测需求吧。eCapture也是自己写了PR支持了Go TLS的明文捕获:support gotls request and response #357。 本次DEMO的测试代码在GitHub仓库:cfc4n/go_uretprobe_demo ,祝大家玩得开心。 写于2023年6月11日,周末,雷阵雨,北京望京。 2023-06-12 0 0